La falacia del kernel compartido: por qué un pod de Kubernetes no basta para agentes que ejecutan código
Los equipos están ejecutando agentes autónomos en pods comunes y tratándolos como microservicios. Cada uno de esos pods comparte un kernel con el resto del nodo. La solución no es un contenedor más endurecido; es un límite distinto.
Los equipos empresariales están colocando agentes de IA autónomos en pods estándar de Docker y Kubernetes y tratándolos como microservicios. Es una bomba de tiempo arquitectónica, porque cada uno de esos pods comparte un único kernel con todo lo demás en el nodo. La solución no es un contenedor más endurecido. Es un límite distinto.
Para precisar la afirmación: se aplica a los agentes que ejecutan código generado, corren comandos de shell u obtienen dependencias, y Kubernetes no es el problema. Lo es el kernel compartido debajo de un pod predeterminado. Corrija el límite y Kubernetes sigue siendo un buen orquestador. Yo construyo infraestructura de virtualización y pasé años vendiéndola, así que pondere mi sesgo en consecuencia y revise las fuentes.
Un agente no es un microservicio
Un microservicio es código que su equipo escribió, revisó y empaquetó en una imagen. Su comportamiento queda acotado en el momento de la compilación. Un agente autónomo no es nada de eso.
| Propiedad | Microservicio | Agente autónomo |
|---|---|---|
| Código que se ejecuta | Revisado, compilado y escaneado antes del despliegue | Generado en tiempo de ejecución, a menudo hace minutos |
| Dependencias | Fijadas en la imagen | Obtenidas bajo demanda (pip install, npm install) |
| Acceso a shell | Casi nunca | Habitual: archivos, git, herramientas de compilación |
| Llamadas a herramientas | Un conjunto fijo de API conocidas | Servidores MCP y herramientas elegidos en tiempo de ejecución |
| Quién decide lo que hace | Sus ingenieros | Un modelo que lee texto no confiable |
La última fila es la que importa. Un modelo que lee páginas web, tickets y documentos puede ser dirigido por lo que esté escrito en ellos. Trate a un agente como un proceso cuyas instrucciones puede reescribir un desconocido, y el modelo de seguridad cambia.
Cómo "solo dele los permisos" se convierte en modo privilegiado
Nadie se propone ejecutar un agente como root en el host. Ocurre una solicitud razonable a la vez.
- El agente necesita instalar un paquete, así que usted relaja las restricciones del sistema de archivos.
- Necesita ejecutar pruebas que inician contenedores, así que monta el socket de Docker o ejecuta Docker-in-Docker.
- Las herramientas de compilación necesitan capacidades adicionales, así que las añade, o configura el pod como privilegiado para dejar de pelear con los mensajes de error.
- Necesita alcanzar API internas, así que la política de red recibe una regla de permiso amplia.
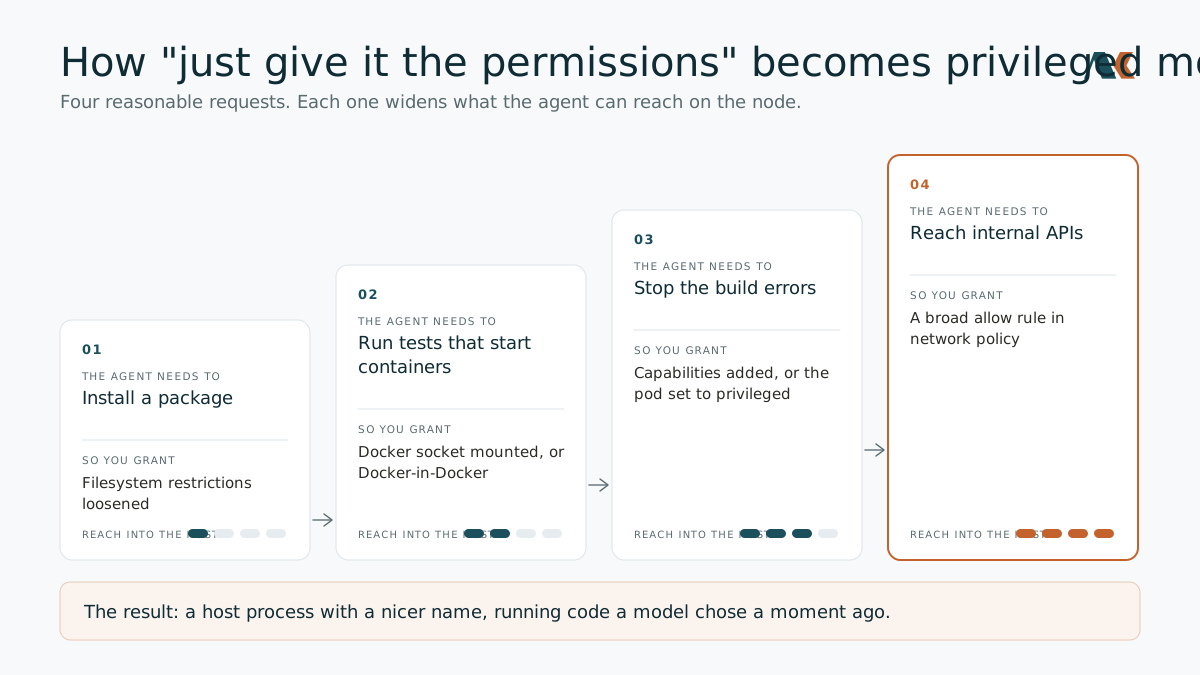
El resultado es un pod con las capacidades necesarias para cargar módulos del kernel o alcanzar el host, ejecutando texto que el modelo eligió hace un momento.
Un contenedor privilegiado no es un límite entre inquilinos. Es un proceso del host con un nombre más amable, y cada otro inquilino de ese nodo ahora comparte su suerte.
Kubernetes tiene salvaguardas precisamente contra esto, y merecen reconocimiento. El Pod Security Standard Baseline prohíbe los pods privilegiados, los volúmenes hostPath (la forma habitual de montar un socket de Docker), las capacidades más allá de una lista corta de capacidades seguras y compartir los namespaces del host. Desde Kubernetes 1.36, los user namespaces tienen disponibilidad general: configure hostUsers: false y root dentro del contenedor se asigna a un usuario sin privilegios en el host. Use ambos. Pero cada paso de la escalada anterior es una solicitud para desactivar uno de ellos, y los agentes son la carga de trabajo que no deja de hacer esa solicitud. Incluso con todas las salvaguardas activas, el kernel sigue siendo compartido.
El kernel compartido es todo el problema
Los contenedores son namespaces y cgroups sobre un único kernel de Linux. Cada llamada al sistema que hace un agente llega al mismo kernel que atiende sus otras cargas de trabajo. Ese límite se ha vulnerado repetidamente, y recientemente. En enero de 2024, Leaky Vessels (CVE-2024-21626) permitió que un proceso de contenedor llegara al sistema de archivos del host a través de un descriptor de archivo que runc filtraba, alcanzable con runc exec o con una imagen maliciosa.
En noviembre de 2025, el proyecto runc divulgó tres fallos de escape de contenedor de severidad alta (CVE-2025-31133, CVE-2025-52565 y CVE-2025-52881). Son condiciones de carrera en la forma en que runc gestiona los montajes y las escrituras en /proc durante el inicio del contenedor. La revisión técnica de la CNCF señala que pueden activarse mediante configuraciones de montaje personalizadas, incluidas las definidas en un Dockerfile, y que uno de ellos (CVE-2025-52881) puede anular el etiquetado de los módulos de seguridad de Linux, lo que deja sin confinar a los procesos confinados por AppArmor. Las versiones afectadas incluían prácticamente todas las publicaciones hasta las correcciones en runc 1.2.8, 1.3.3 y 1.4.0-rc.3.
Ahora ponga eso junto al comportamiento de un agente, con una precisión. Estos fallos requieren la capacidad de iniciar contenedores con una imagen o una configuración de montaje elegidas, y ejecutar una compilación basta. Así que un agente confinado en un pod común solo está expuesto si puede ejecutar compilaciones, publicar imágenes o dar forma a las especificaciones de los pods. El peligro aparece cuando usted le da esos medios: un socket de Docker montado, Docker-in-Docker o nodos de compilación compartidos. Los agentes piden exactamente eso, porque compilar imágenes y ejecutar Dockerfiles es parte del trabajo. Estos errores concretos están corregidos. La lección es la clase: los escapes del runtime y del kernel siguen apareciendo, y una plataforma que permite a los agentes iniciar contenedores está apostando a que aplicará los parches antes de que alguien lo intente.
La capa de herramientas añade más. Un análisis de seguridad contabiliza unas 30 CVE registradas contra servidores MCP en menos de 60 días a partir de enero de 2026, con la inyección de comandos entre los fallos más comunes. Tome la cifra exacta como indicativa, ya que es un recuento secundario. Ese patrón es fácil de entender: un servidor MCP que pasa a una shell la entrada proporcionada por el modelo ha convertido un prompt en un comando. A partir de ahí, el camino más corto hacia el daño suele pasar por lo que alcancen las credenciales y la red de ese servidor. El camino más largo pasa por el kernel: si el servidor comparte un nodo con su servicio de pagos, un escape del runtime o del kernel convierte una sola cadena manipulada en un día muy malo. Una microVM cierra el segundo camino, no el primero, y por eso los controles de credenciales y de salida que se describen más abajo importan tanto como el límite.
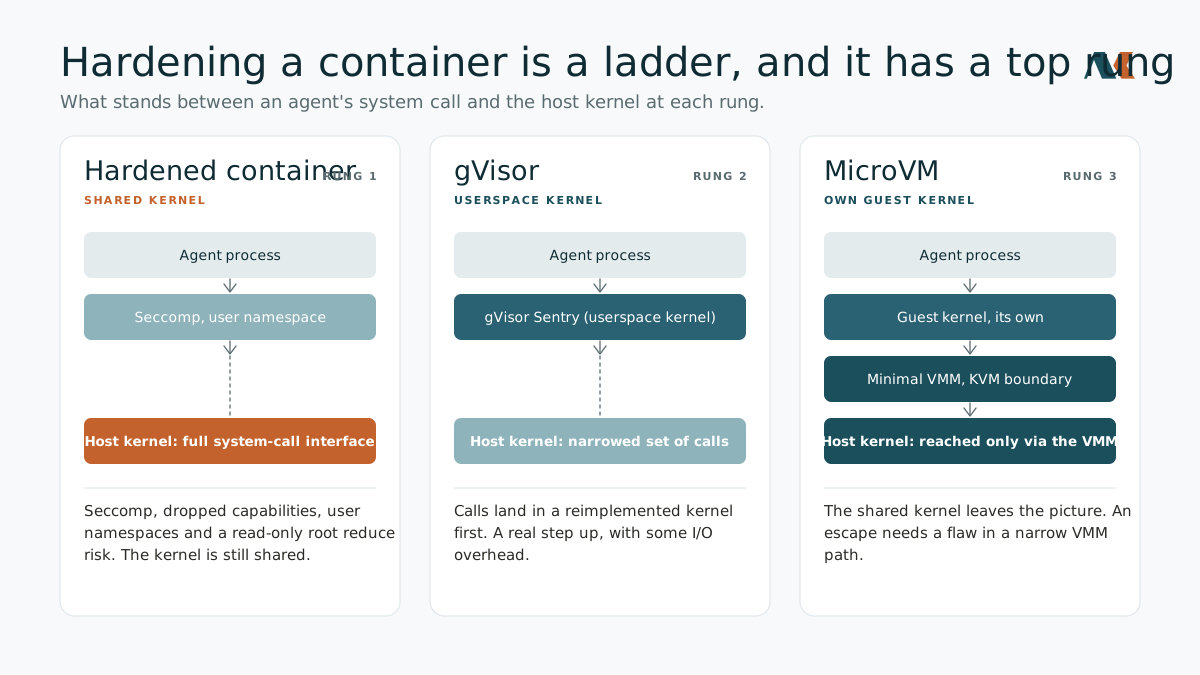
Endurecer un contenedor es una escalera, y tiene un último peldaño
Los equipos de seguridad sí tienen opciones, y conviene ser honestos sobre ellas.
- Contenedores simples con perfiles restringidos. Seccomp, capacidades eliminadas, sistemas de archivos raíz de solo lectura y user namespaces reducen el riesgo. El kernel sigue siendo compartido.
- gVisor. Un kernel en espacio de usuario intercepta las llamadas al sistema, de modo que la aplicación habla con una reimplementación en lugar del kernel del host. Un avance real, con cierta sobrecarga de E/S (una guía de practicantes la sitúa entre el 10 y el 30 por ciento en trabajo intensivo en E/S).
- MicroVM aisladas por hardware. Cada carga de trabajo recibe su propio kernel invitado detrás de un límite KVM que impone la CPU.
La comunidad de Kubernetes lo ha notado. SIG Apps lanzó el proyecto Agent Sandbox en KubeCon North America en noviembre de 2025: un recurso personalizado Sandbox para runtimes de agentes aislados, con estado y de instancia única, respaldado por gVisor o Kata Containers, con pools precalentados para que el inicio tarde menos de un segundo. Es una señal clara de que el pod predeterminado no se considera suficiente para los agentes.
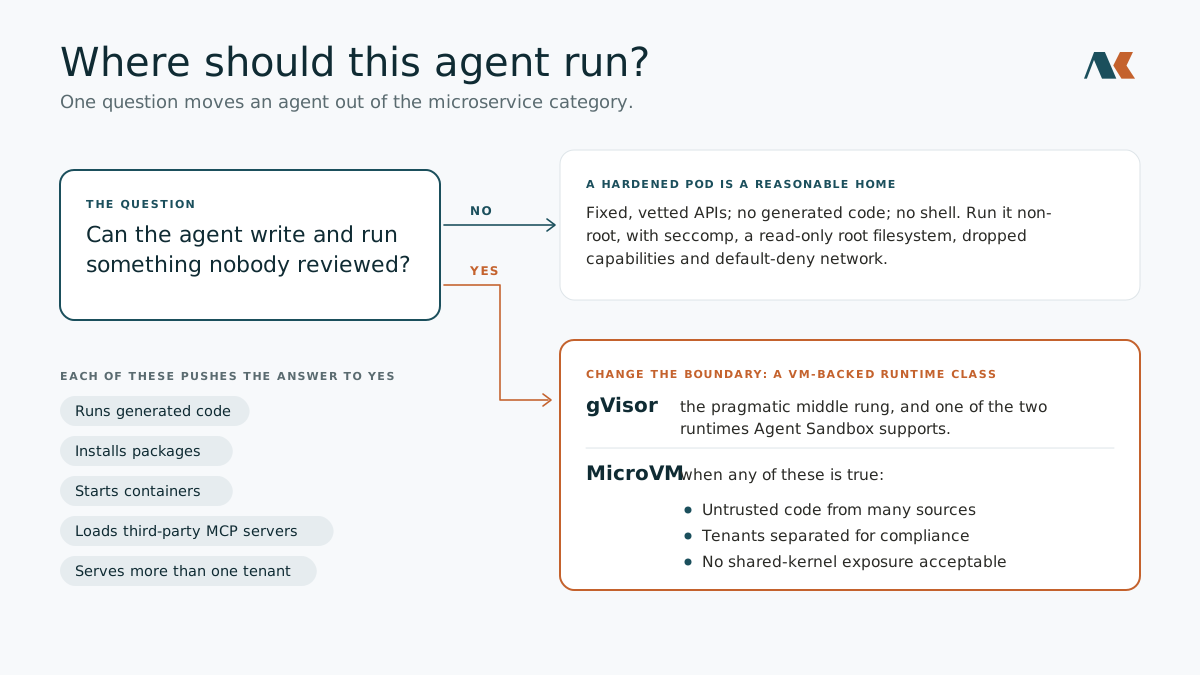
Los peldaños difieren en naturaleza, no solo en grado. gVisor reduce lo que un proceso hostil puede alcanzar en el kernel del host. Una microVM saca el kernel compartido de la ecuación. Para muchos equipos, gVisor es el peldaño intermedio pragmático, y es uno de los dos runtimes que admite Agent Sandbox. Elija una microVM cuando los agentes ejecuten código no confiable de muchas fuentes, cuando los inquilinos deban separarse por cumplimiento normativo o cuando no pueda aceptar ninguna exposición a un kernel compartido.
Cuándo un contenedor sigue siendo adecuado
No todos los agentes necesitan una microVM. Un agente que llama a un conjunto fijo de API evaluadas, no ejecuta código generado y no tiene shell está mucho más cerca de un microservicio. Un pod endurecido (sin root, seccomp, sistema de archivos raíz de solo lectura, capacidades eliminadas, red con denegación por defecto) es un lugar razonable para él.
El riesgo aumenta con cada capacidad que usted añade: ejecutar código generado, instalar paquetes, iniciar contenedores, cargar servidores MCP de terceros o atender a más de un inquilino. Una regla útil: en el momento en que un agente puede escribir y ejecutar algo que usted no revisó, ha salido de la categoría de microservicio, y el límite debe cambiar con él.
Por qué las microVM se ajustan a cómo funcionan realmente los agentes
El argumento se apoya en cuatro propiedades.
1. El privilegio deja de dar miedo. Dentro de una microVM, el agente puede ser root, instalar cualquier cosa y ejecutar Docker, porque el kernel invitado es suyo. Un agente "privilegiado" tiene privilegios sobre una máquina desechable, no sobre su nodo. Esta es la propiedad que resuelve la trampa de los permisos descrita arriba: puede decirle que sí al agente sin decirle que sí al host.
2. La superficie de ataque es pequeña y distinta. Un contenedor puede alcanzar toda la interfaz de llamadas al sistema del kernel del host. Un invitado de microVM alcanza un monitor de máquina virtual mínimo. Firecracker, el VMM creado por AWS que está detrás de Lambda y Fargate, está escrito en Rust, emula una lista deliberadamente corta de dispositivos e incluye un jailer que envuelve el VMM en su propio chroot, namespaces y cgroups, mientras que el propio Firecracker aplica filtros seccomp por hilo. Un escape ahora requiere un fallo en ese camino estrecho, en lugar de en cualquiera de los varios cientos de llamadas al sistema del kernel del host.
3. Es lo bastante rápida como para ser desechable. Firecracker documenta un inicio en espacio de usuario de unos 125 milisegundos, menos de 5 MiB de sobrecarga de memoria por microVM y tasas de creación de hasta 150 por segundo por host. Esa cifra es el tiempo hasta el init del invitado, así que el runtime del agente y los paquetes que use se suman. Aun así, un inicio medido en fracciones de segundo es lo que hace que una microVM por tarea sea práctica en lugar de una aspiración.
4. El desmontaje es un límite, no un script de limpieza. Lo que nos lleva a los residuos.
Desechable por diseño: sin residuos de credenciales
Los pods de larga duración acumulan secretos. Los tokens quedan en variables de entorno, en el historial de la shell, en las cachés de los gestores de paquetes, en directorios temporales y en el swap. Un contenedor "limpio" reutilizado para la siguiente tarea puede entregarle a esa tarea las claves de la anterior.
Una microVM efímera cambia el comportamiento predeterminado:
- Una tarea, una máquina. El disco con escritura y la memoria del invitado se descartan cuando termina la tarea. No hay nada que limpiar dentro del invitado, aunque lo que usted haya montado dentro o enviado fuera sigue siendo su responsabilidad.
- Los secretos se quedan fuera. Siga el patrón que Google Cloud describe para Agent Compute Engine, anunciado en octubre de 2026 y previsto para vista previa: las credenciales de larga duración nunca entran en el sandbox, y una pasarela inyecta el acceso en nombre del agente. Un invitado comprometido no puede llevarse las credenciales, pero durante la sesión aún puede usar el acceso que conceda la pasarela, así que limite ese acceso y su presupuesto de forma estricta.
- Salida con denegación por defecto. El sandbox solo alcanza los destinos que usted enumeró, de modo que una herramienta envenenada no puede comunicarse con el exterior.
- Trate las instantáneas como sensibles. La creación y restauración de instantáneas hace rápidos los pools precalentados, pero una instantánea captura la memoria. Guárdela con el mismo cuidado que los secretos que pueda contener. Restaurar muchas microVM a partir de una sola instantánea también copia un estado que debía ser único: la documentación de Firecracker advierte que identificadores, números aleatorios y tokens criptográficos pueden terminar usándose dos veces, y VMGenID solo vuelve a sembrar la entropía del kernel invitado. Dé a cada clon su propia identidad y sus propias claves después de restaurarlo.
Una salvedad de la literatura sobre sandboxing merece repetirse: el aislamiento contiene la ejecución, no el propósito. Un agente autorizado a enviar datos a un destino aprobado todavía puede enviar los datos equivocados. El límite del kernel es la base. La identidad, la política y la auditoría se apoyan sobre ella.
Lo que cuestan las microVM
El argumento es sólido, no gratuito.
- No son irrompibles. Los hipervisores y los VMM también han tenido errores de escape, incluida una fuga de invitado a host en qemu-kvm publicada en 2011 (Virtunoid, CVE-2011-1751). La afirmación es una superficie de ataque mucho menor más defensa en profundidad, no riesgo cero.
- Necesitan KVM. Eso significa bare metal o virtualización anidada, que no todos los tipos de instancia en la nube ofrecen y que puede costar rendimiento.
- El inicio tiene capas. La cifra de 125 milisegundos cubre llevar al invitado hasta init. El runtime y las dependencias del agente vienen después, y por eso importan los pools precalentados y las instantáneas.
- Algunas cosas son más difíciles. El acceso a GPU, los sistemas de archivos compartidos y la observabilidad detallada requieren más diseño que en un pod simple.
Kubernetes puede quedarse
Nada de esto exige abandonar su clúster. Kata Containers ejecuta cada pod dentro de su propia VM ligera, usando QEMU, Cloud Hypervisor, Firecracker o Dragonball, entre otros, mientras presenta la API normal de Kubernetes. Agent Sandbox selecciona la capa de aislamiento mediante una runtime class. Puede conservar la planificación, la red, la observabilidad y RBAC, y cambiar lo que hay debajo del pod.
El principio de diseño es simple: orquestar con Kubernetes, aislar con hardware.
Qué hacer antes de que sus agentes lleguen a producción
- Encuentre los pods privilegiados. Busque privileged: true, sockets de Docker montados, capacidades añadidas y volúmenes hostPath en cualquier namespace que ejecute agentes. Cada uno es un hallazgo.
- Traslade las cargas de trabajo de agentes a una runtime class respaldada por VM. Kata o un sandbox basado en microVM, no el runtime predeterminado.
- Una tarea de agente por sandbox, destruido al final. Sin reutilización entre inquilinos ni entre tareas.
- Mantenga las credenciales fuera del invitado. Use un patrón de acceso intermediado y tokens de corta duración.
- Aplique Pod Security en los namespaces de agentes. Baseline como mínimo, Restricted donde pueda, para que cada excepción privilegiada sea una decisión visible y revisada.
- Active los user namespaces donde el runtime los admita. Con hostUsers: false, root en el contenedor no es root en el host.
- Aplique parches al runtime de todos modos. Compruebe que los nodos ejecuten una versión corregida de runc, ya que la defensa en profundidad sigue incluyendo la capa del kernel compartido para todo lo demás que usted ejecuta.
- Registre en el límite. Registre lo que cada sandbox inició, alcanzó y escribió, de forma que cualquier alteración sea evidente, para poder reconstruir una sesión.
La conclusión
Los contenedores se diseñaron para empaquetar software en el que su equipo confía. Los agentes autónomos son software que decide qué ejecutar después de publicarse. Poner los que ejecutan código que nadie revisó en el mismo kernel que sus servicios de producción es un error de categoría, por bien configurado que esté el pod.
La infraestructura que gestione bien a los agentes se parecerá menos a un host de Docker más grande y más a una flota de máquinas virtuales pequeñas y desechables, iniciadas en una fracción de segundo y eliminadas cuando termina la tarea. Los hipervisores han pasado dos décadas aprendiendo a mantener separadas las cargas de trabajo hostiles. Los agentes son la razón para volver a usar esa lección.
Preguntas frecuentes
¿Qué es un contenedor? Es una forma de empaquetar una aplicación y ejecutarla aislada de otras aplicaciones en el mismo servidor. Los contenedores son ligeros y rápidos porque todos toman prestado el mismo núcleo del sistema operativo.
¿Qué es un kernel y qué significa "kernel compartido"? El kernel es el núcleo del sistema operativo, la parte que controla la memoria, los archivos y el hardware. Los contenedores de un mismo servidor comparten un único kernel, así que un fallo en él puede exponer a todos los contenedores de ese servidor.
¿Qué es una microVM? Es una máquina virtual muy pequeña con su propio kernel, que se inicia en una fracción de segundo. Como el kernel no se comparte, un problema dentro de ella se queda dentro de ella.
¿Qué significa "privilegiado" para un contenedor? Significa que el contenedor recibe poderes cercanos a los del propio host. Un contenedor privilegiado ya no es un límite seguro entre inquilinos, y por eso concedérselo a un agente es arriesgado.
¿Qué es un servidor MCP? El Model Context Protocol es una forma estándar de que un agente de IA use herramientas externas, como una base de datos o un sistema de tickets. Un servidor MCP es el programa que expone una de esas herramientas al agente.
¿No basta con Pod Security de Kubernetes? Bloquea los pods privilegiados, los montajes del host y las capacidades adicionales, y debería estar activo en cada namespace que ejecute agentes. No cambia lo que hay debajo: un agente en un pod que cumple plenamente sigue compartiendo el kernel del nodo con todo lo demás.
¿Qué son los user namespaces? Una función de Linux, con disponibilidad general en Kubernetes desde la versión 1.36, que asigna root dentro de un contenedor a un usuario común en el host. Limita lo que puede hacer un escape, pero el kernel sigue siendo compartido.
¿Qué es gVisor? Un kernel escrito en espacio de usuario que se sitúa entre un contenedor y el kernel del host y responde por sí mismo a la mayoría de las llamadas al sistema. Reduce lo que llega al kernel del host, con cierto costo en rendimiento de E/S.
¿Tengo que renunciar a Kubernetes? No. Kubernetes puede seguir planificando y gestionando sus cargas de trabajo mientras un runtime basado en VM, como Kata Containers, proporciona el aislamiento por debajo. El cambio está en lo que hay debajo del pod, no en cómo opera el clúster.
¿Todo agente de IA necesita una microVM? No. Un agente que solo llama a un conjunto fijo de API evaluadas y no ejecuta código generado está mucho más cerca de un servicio común, y un contenedor endurecido puede bastarle. El riesgo aumenta cuando el agente puede escribir y ejecutar cosas que nadie revisó.
¿Qué es Kata Containers? Un runtime de código abierto que ejecuta cada pod de Kubernetes dentro de su propia máquina virtual ligera, usando un hipervisor como QEMU, Cloud Hypervisor, Firecracker o Dragonball. El clúster sigue viendo un pod común.
¿Qué es Firecracker? Un monitor de máquina virtual de código abierto creado por AWS y usado detrás de Lambda y Fargate. Su documentación sitúa el inicio hasta el init del invitado en unos 125 milisegundos, con menos de 5 MiB de sobrecarga de memoria por microVM.
¿Qué es Agent Sandbox? Un proyecto de SIG Apps de Kubernetes lanzado en noviembre de 2025. Añade un recurso Sandbox para runtimes de agentes aislados y con estado, respaldado por gVisor o Kata Containers, con pools precalentados que hacen que el inicio tarde menos de un segundo.
¿Cómo encuentro pods de agentes riesgosos en mi clúster? Busque privileged: true, sockets de Docker montados, capacidades añadidas y volúmenes hostPath en cualquier namespace que ejecute agentes. Aplicar el Pod Security Standard Baseline convierte cada uno de ellos en una solicitud rechazada o en una excepción revisada.
¿Una microVM detiene la inyección de prompts? No. Limita lo que un agente secuestrado puede alcanzar en el host, pero un agente autorizado a llamar a una herramienta o a un destino aprobados todavía puede ser dirigido a usarlos de forma indebida. Las credenciales mantenidas fuera del sandbox, el tráfico saliente con denegación por defecto y el registro en el límite se encargan del resto.
¿Cuesta más ejecutar microVM? Necesitan KVM, lo que significa bare metal o virtualización anidada, y cada sandbox añade cierta sobrecarga de memoria y de inicio. Los pools precalentados y las instantáneas reducen el tiempo de inicio, pero cada clon restaurado necesita su propia identidad y sus propias claves.
Cheick M Ouedraogo pasó unos ocho años en ventas de tecnología empresarial, incluidas VMware y Broadcom, antes de fundar Aurakore, donde construye infraestructura de virtualización y de IA privada. Escribe sobre lo que los compradores deberían preguntar y lo que la documentación dice realmente.
Fuentes
- runc container breakout vulnerabilities: a technical overview, CNCF, nov. 2025
- runc security advisory GHSA-cgrx-mc8f-2prm (CVE-2025-52881), proyecto runc
- runc security advisory GHSA-xr7r-f8xq-vfvv (CVE-2024-21626), proyecto runc, ene. 2024
- Kubernetes v1.36: User Namespaces in Kubernetes are finally GA, blog de Kubernetes, abr. 2026
- Pod Security Standards, documentación de Kubernetes
- Firecracker snapshot support, proyecto Firecracker
- New runc vulnerabilities allow container escape, Sysdig, nov. 2025
- Running Agents on Kubernetes with Agent Sandbox, blog de Kubernetes, mar. 2026
- Unleashing autonomous AI agents: why Kubernetes needs a new standard for agent execution, Google Open Source Blog, nov. 2025
- Kubernetes Agent Sandbox guide, Pulumi
- AI Agent Sandboxing Explained: Why Docker Is Not Enough, SoftwareSeni
- Firecracker, secure and fast microVMs, proyecto Firecracker
- Firecracker: lightweight virtualization for serverless, LWN.net
- MCP Security: 30 CVEs in 60 Days, Noqta
- MCP Security Vulnerabilities: Complete Threat Inventory, Obsidian Security
- Agent Compute Engine deep dive, blog de Google Cloud, oct. 2026
- AI Agent Sandboxing, Prediction Guard, actualizado en ago. 2026
Este artículo trata sobre Aurakore Virtualization.
Ver Aurakore Virtualization