Compartir una GPU sin compartir sus datos: passthrough, vGPU y MIG comparados
Compartir una GPU es un equilibrio a tres bandas entre aislamiento, aprovechamiento y operabilidad. Una comparación para compradores de passthrough, vGPU por tiempo compartido y MIG, lo que ocurre la noche de los parches y seis preguntas que hacer a cualquier plataforma.
Compartir una GPU es un equilibrio a tres bandas entre aislamiento, aprovechamiento y operabilidad, y la mayoría de las presentaciones de plataformas solo hablan de los dos primeros. El tercero es donde los equipos se llevan sorpresas: qué le pasa a una carga de trabajo de GPU cuando hay que aplicar parches al host.
A medida que los modelos privados y los agentes pasan a hardware compartido, es cada vez más habitual que una GPU cara sirva a varios equipos. Pasé unos ocho años vendiendo infraestructura de VMware y Broadcom, así que escribo esto desde el lado del comprador: qué preguntar, qué comprobar y dónde se acaba la documentación. Este artículo compara las tres formas principales de compartir una GPU y las preguntas que las distinguen.
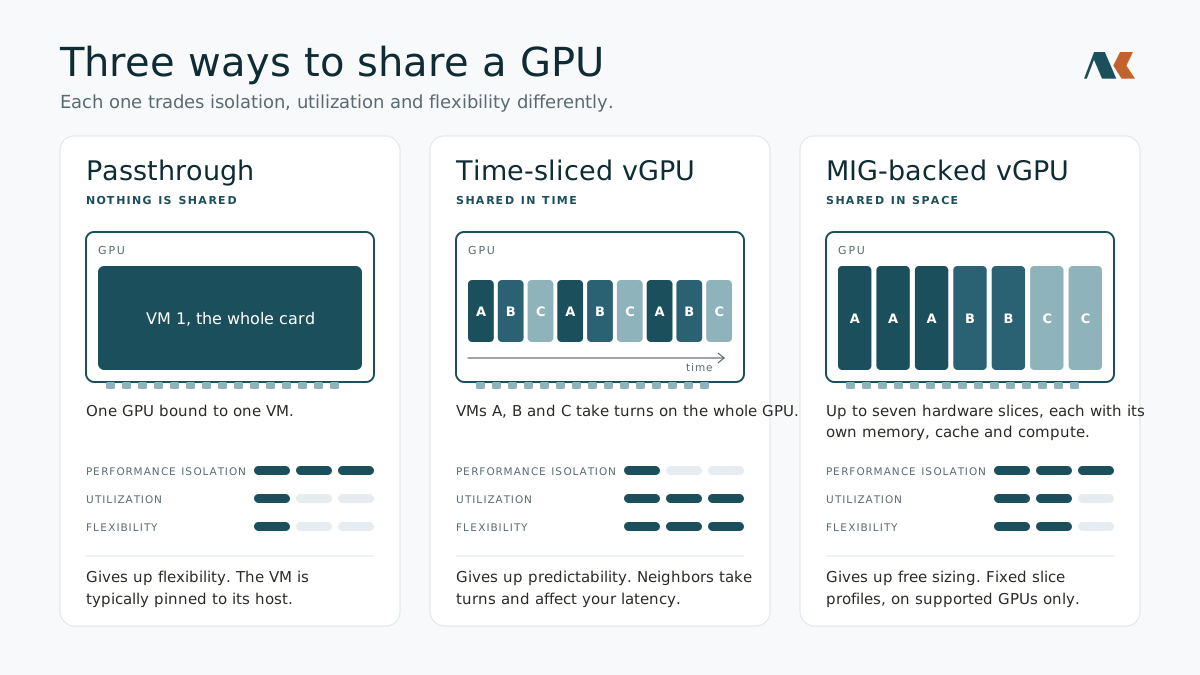
Tres formas de compartir una GPU
| Método | Qué se comparte | Aislamiento | Impacto en las operaciones |
|---|---|---|---|
| Passthrough | Nada. Una GPU se asigna a una VM | El más fuerte y el más simple | El estado del dispositivo reside en la tarjeta, así que la VM suele quedar fijada a su host |
| vGPU por tiempo compartido | La GPU completa, multiplexada en el tiempo | La memoria está aislada por la IOMMU; el aislamiento del rendimiento es temporal, así que los vecinos afectan a su latencia | La migración en vivo está soportada en las versiones actuales de vSphere y KVM, pero hay que copiar la memoria de la GPU |
| Basada en MIG (Multi-Instance GPU) | Particiones de hardware, hasta siete por GPU | Espacial: cada partición tiene su propia memoria, caché y cómputo, con aislamiento de fallos y rendimiento predecible | Perfiles de partición predefinidos; una partición MIG por VM, y una GPU funciona con perfiles MIG o de tiempo compartido, no ambos. Solo GPU compatibles: NVIDIA enumera Ampere, Hopper y Blackwell, mientras que la guía de diseño de VCF 9.1 de Broadcom enumera Ampere y Hopper |
La propia documentación de NVIDIA traza la línea con claridad. Las vGPU por tiempo compartido se turnan en la GPU completa, así que los procesos se ejecutan en serie. Las vGPU basadas en MIG obtienen particiones de hardware dedicadas y se ejecutan de verdad en paralelo, y por eso NVIDIA las recomienda para trabajo multiinquilino y una latencia constante.
Una advertencia sobre la tabla: ahí "aislamiento" significa dos cosas distintas, y fallan de maneras distintas.
El aislamiento son dos preguntas: rendimiento y datos
El aislamiento del rendimiento pregunta si un vecino ruidoso puede perjudicar su latencia. El tiempo compartido dice que sí, por diseño. MIG dice que no, porque los recursos están divididos físicamente. Para la inferencia con objetivos de latencia, este suele ser el factor decisivo.
El aislamiento de los datos pregunta si un inquilino puede leer los restos de otro. Es el que se da por supuesto y rara vez se prueba. La vulnerabilidad LeftoverLocals (CVE-2023-4969), divulgada por Trail of Bits en enero de 2024, mostró que en las GPU de AMD, Apple, Qualcomm e Imagination afectadas un proceso podía leer datos que un proceso anterior había dejado en la memoria local de la GPU, incluidos fragmentos de la sesión de LLM de otro usuario. Los investigadores informaron de que los dispositivos de NVIDIA y Arm no estaban afectados.
La lección no trata de ningún proveedor en concreto. Su artículo señala que los enfoques de partición conservadores, como la vGPU, dividen físicamente la GPU y por eso probablemente evitan este tipo de fuga, pero afirman que carecen de pruebas concluyentes. Mientras tanto, bastaba con compartir una GPU mediante la planificación multiproceso habitual para exponer el problema, también dentro de contenedores.
Si la memoria se borra entre inquilinos, y con qué mecanismo, es una propiedad por la que hay que preguntar, no algo que se pueda dar por supuesto.
La parte que nadie presupuesta: las operaciones
Una VM con una GPU conectada lleva mucho estado. Para migrarla en vivo, la plataforma también tiene que copiar la memoria de la GPU, y la VM se pausa para el cambio final.
Esto era antes un problema operativo serio, y muestra por qué las afirmaciones de los proveedores necesitan fechas. En vSphere 7 y en 8.0 antes de Update 2, DRS no sacaba automáticamente las VM con vGPU de un host que entraba en modo de mantenimiento, porque la pausa podía superar los 100 segundos, así que los administradores las movían a mano. vSphere 8.0 Update 2 permitió que DRS estimara la pausa y automatizara el traslado cuando queda por debajo de un límite configurable, 100 segundos por defecto, una vez que un administrador activa esa automatización. En VCF 9.1 sigue siendo opcional: la guía de diseño 9.1 de Broadcom indica que, por defecto, DRS deja las VM con vGPU para corrección manual, y solo las mueve automáticamente para equilibrar la carga o por mantenimiento cuando está activada la opción PassthroughDrsAutomation.
VMware Cloud Foundation 9.0 (junio de 2025) cambió el panorama. Broadcom rediseñó la forma en que vMotion copia el punto de control de la vGPU, sustituyendo un canal de un solo hilo por uno multihilo. Las notas de la versión de VCF 9.0 y la guía de diseño 9.1 de Broadcom explican el resto: a partir de ESX 9.0, vMotion distingue la memoria estática de la GPU de la memoria que está cambiando. La parte estática, que Broadcom sitúa en torno al 70% para la inferencia de LLM y que son sobre todo los pesos del modelo, se copia mientras la VM sigue funcionando; solo los datos que cambian, como la KV cache, se copian durante la pausa. Broadcom informa de pausas entre tres y cuatro veces más cortas que en vSphere 8.0 Update 3. En sus pruebas, una VM con ocho GPU H100 de 80 GB se pausó 21 segundos, una configuración que alcanzaba el límite por defecto de 100 segundos en 8.0 Update 3. Broadcom considera ahora que vMotion es práctico para perfiles de vGPU de 48 GB, 80 GB y mayores.
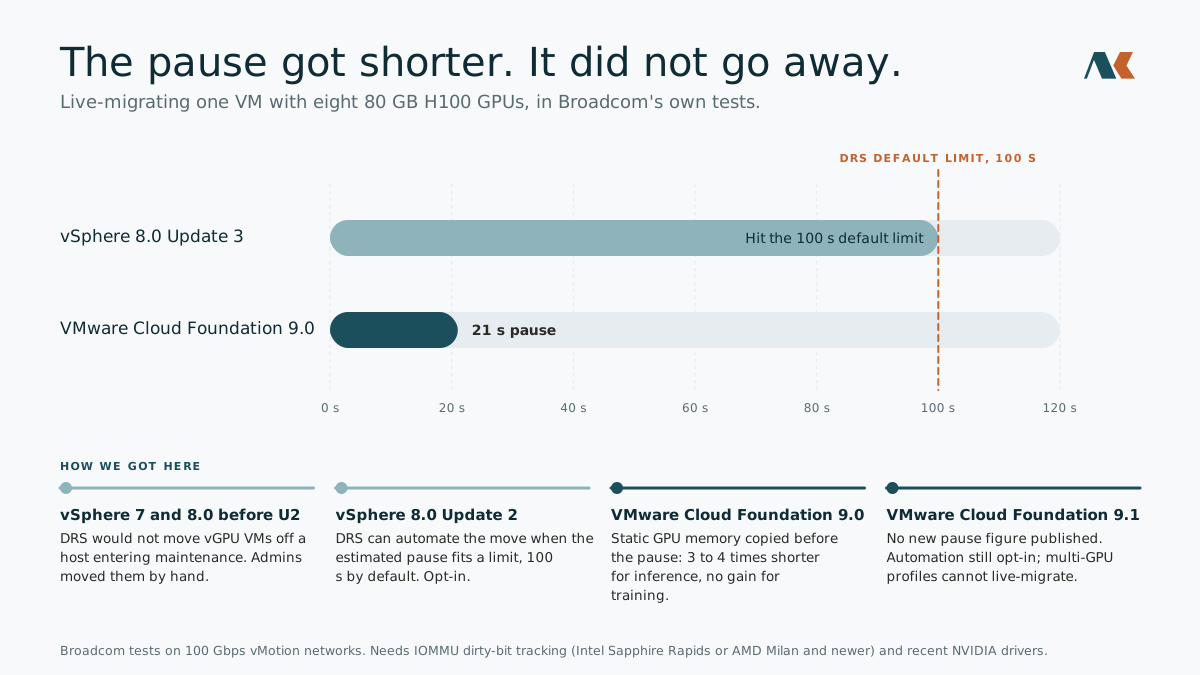
Lea esos resultados con sus condiciones. Son pruebas propias de Broadcom en redes de vMotion de 100 Gbps, y las mejoras dependen del seguimiento de bits sucios de la IOMMU, que requiere Intel Sapphire Rapids o posterior, o AMD Milan o posterior, junto con generaciones recientes de controladores de NVIDIA. La pausa sigue existiendo; es más corta. Cualquier plataforma que migre en vivo una VM con GPU conectada tiene que mover la memoria de la GPU, así que las preguntas útiles son sobre las condiciones: qué CPU, qué red, qué controladores y cuánta pausa tolera su carga de trabajo.
VCF 9.1 no ha publicado una pausa más corta. La FAQ de vSphere 9.1 de Broadcom incluye "un vMotion más rápido para cargas de trabajo de GPU" entre lo destacado de la versión, pero ni las notas de la versión 9.1 ni la guía de diseño 9.1 dan una cifra nueva ni un mecanismo nuevo para vGPU. Lo que añade 9.1 es una estimación del tiempo de inactividad de vMotion en vCenter para las VM con dispositivos Enhanced DirectPath. La guía de diseño recoge el mecanismo de ESX 9.0 y el mismo valor por defecto de 100 segundos, y se aplican dos salvedades. Las notas de la versión 9.0 de Broadcom dicen que la precopia ayuda a la inferencia de IA generativa pero no tiene ningún efecto en las cargas de trabajo gráficas y de entrenamiento. Y las VM que usan Unified Virtual Memory, que exigen los perfiles multi-GPU, no se pueden migrar en vivo en absoluto y hay que apagarlas para el mantenimiento.
Para la inferencia sin estado, a menudo la mejor respuesta es la evacuación por sustitución: ejecutar réplicas en varios hosts, vaciar uno y dejar que los demás absorban el tráfico. Eso convierte el mantenimiento de un host de un problema de migración en un problema de planificación. Es una decisión de diseño, no una garantía, y funciona mejor cuando las particiones se dimensionan para que cualquier réplica pueda tomar el relevo.
VCF 9.1 ayuda con el propio vaciado, para todas las VM y no solo las que tienen GPU. Una nueva opción del modo de mantenimiento evacúa las VM solo cuando los hosts restantes pueden absorber su demanda, y DRS puede reequilibrar antes esos hosts. Las tareas de vMotion también empiezan a medida que termina cada una, en lugar de esperar a que se complete un lote de ocho.
La pila que hay debajo
NVIDIA vGPU no es por sí sola una función del hipervisor. Es una pila por capas: un controlador de host del proveedor instalado en el hipervisor, un controlador correspondiente dentro de cada invitado y un servicio de licencias al que los invitados deben poder llegar. Ejecutar IA sobre vGPU requiere una licencia de NVIDIA AI Enterprise, sea cual sea el hipervisor que utilice.
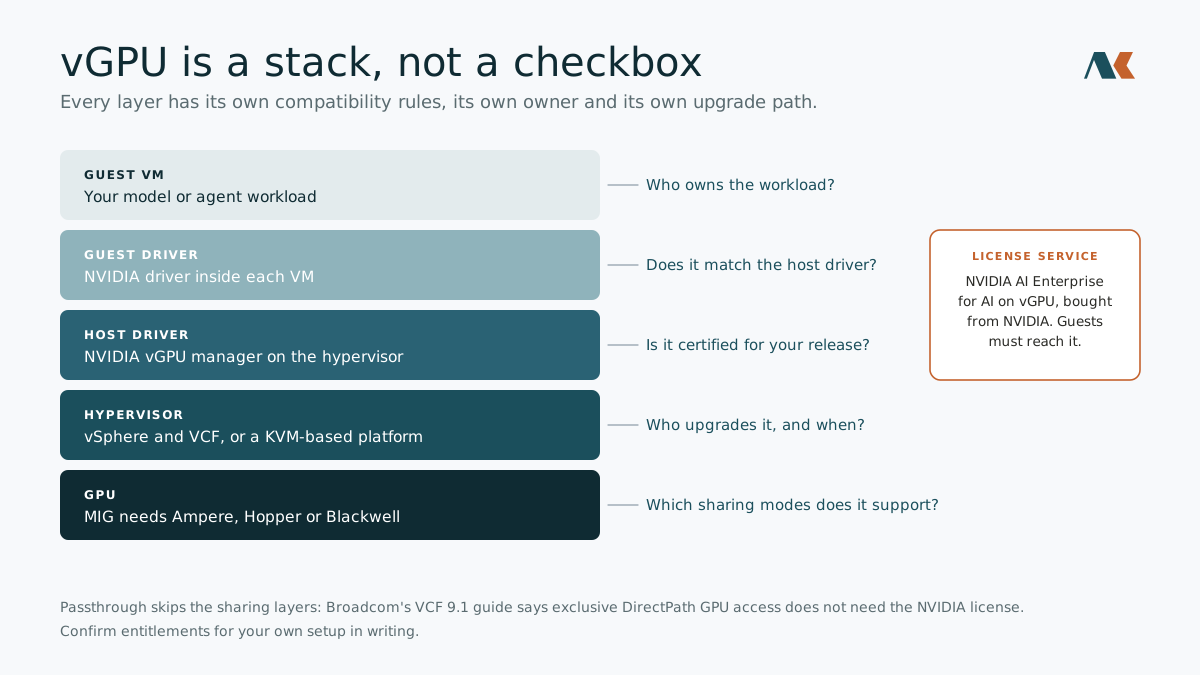
En VMware Cloud Foundation, los derechos de uso han ido cambiando. Broadcom anunció en VMware Explore 2025 que Private AI Foundation with NVIDIA pasaba a formar parte de la suscripción estándar de VCF, aunque parte de la documentación de Broadcom todavía menciona una licencia complementaria aparte, así que confirme sus derechos de uso por escrito. La licencia de NVIDIA AI Enterprise se sigue comprando a NVIDIA, no a Broadcom. La guía de VCF 9.1 de Broadcom indica que el acceso exclusivo a la GPU mediante DirectPath passthrough no requiere la licencia de NVIDIA, lo que coincide con la propia documentación de certificación de hipervisores de NVIDIA.
Cada capa tiene sus propias reglas de compatibilidad. La página de requisitos de Broadcom indica que el controlador de host de NVIDIA debe ser compatible con su versión de VCF, y el vMotion más rápido descrito arriba depende de generaciones de controladores más recientes. Es algo rutinario, y es la razón por la que compartir una GPU debe evaluarse como una pila con responsables y rutas de actualización, no como una casilla. Lo mismo ocurre en las plataformas basadas en KVM, donde cada proveedor integra la versión genérica de vGPU para KVM de NVIDIA.
Seis preguntas que hacer a cualquier plataforma
- ¿El aislamiento es temporal o espacial? ¿El trabajo de un vecino cambiará mi latencia?
- ¿Qué se borra entre inquilinos, y quién lo comprueba? Pida el mecanismo, no la promesa.
- ¿Cómo vacío un host de GPU para el mantenimiento? ¿Qué les pasa a las cargas de trabajo en ejecución, y cuánto tiempo quedan en pausa?
- ¿De qué depende la pila de uso compartido? ¿Qué componentes, qué licencias y quién aplica los parches a cada uno?
- ¿Puedo redimensionar las particiones sin una ventana de mantenimiento? Las instancias MIG se pueden reconfigurar, pero compruebe qué permite la plataforma mientras las cargas de trabajo se ejecutan.
- ¿Puedo atribuir el uso de la GPU a cada inquilino? La refacturación interna y la planificación de capacidad lo necesitan.
La conclusión
Elegir un modo de uso compartido de la GPU es elegir cómo fallar: la latencia de quién sufre, los datos de quién podrían filtrarse y qué ocurre la noche de los parches.
Passthrough maximiza el aislamiento y renuncia a la flexibilidad. El tiempo compartido maximiza el aprovechamiento y renuncia a la previsibilidad. La partición al estilo MIG ofrece particiones predecibles y aisladas a cambio de tamaños fijos y hardware compatible.
Elija lo que elija, evalúe la pila completa y las operaciones que la rodean. La plataforma que responde con claridad a las seis preguntas suele ser la que ya se ha topado con los problemas que hay detrás de ellas.
Preguntas frecuentes
¿Qué es una vGPU? Es software que permite que varias máquinas virtuales compartan una GPU física. Cada máquina ve su propia GPU virtual, y el controlador del host decide cuánto de la tarjeta real recibe cada una.
¿Qué es MIG? Multi-Instance GPU es una función de NVIDIA que divide en hardware una GPU compatible en hasta siete partes independientes. Cada parte tiene su propia memoria y su propio cómputo, de modo que la carga de trabajo de un inquilino no puede ralentizar la de otro.
¿Cuál es la diferencia entre passthrough y vGPU? Passthrough da a una máquina virtual la GPU completa, así que no se comparte nada. La vGPU reparte una GPU entre varias máquinas, lo que aprovecha mejor la tarjeta pero añade reglas de uso compartido que hay que gestionar.
¿Puede otro inquilino ver mis datos en una GPU compartida? Depende de cómo se comparta la GPU y de cómo se borre la memoria entre usuarios. Un fallo de 2024 llamado LeftoverLocals permitía que un proceso leyera datos dejados por otro en algunas GPU de AMD, Apple, Qualcomm e Imagination. Por eso la pregunta que hay que hacer es qué se borra y quién lo comprueba.
¿Qué es la migración en vivo, y por qué una GPU la complica? La migración en vivo traslada una máquina virtual en ejecución a otro servidor sin apagarla. Con una GPU conectada, la plataforma también tiene que copiar la memoria de la GPU, así que la máquina se pausa durante un breve tiempo al final. Las versiones más recientes acortan esa pausa, pero no desaparece, y las VM que usan perfiles multi-GPU no se pueden migrar en vivo en absoluto.
¿Necesito una licencia de NVIDIA aparte? Ejecutar IA sobre vGPU requiere una licencia de NVIDIA AI Enterprise, que se compra a NVIDIA sea cual sea el hipervisor que utilice. La guía de VCF 9.1 de Broadcom indica que passthrough, en el que una VM recibe una GPU completa, no la requiere. Confirme por escrito las condiciones para su propia configuración antes de comprar.
Cheick M Ouedraogo pasó unos ocho años en ventas de tecnología empresarial, incluidas VMware y Broadcom, antes de fundar Aurakore, donde construye infraestructura de virtualización y de IA privada. Escribe sobre lo que los compradores deberían preguntar y lo que la documentación dice realmente.
Fuentes
- NVIDIA vGPU Types Reference, documentación de NVIDIA AI Enterprise
- NVIDIA vGPU for Compute, documentación de NVIDIA AI Enterprise
- NVIDIA Virtual GPU Knowledge Base: vGPU features across hypervisors, NVIDIA
- NVIDIA Multi-Instance GPU, NVIDIA
- Enhanced vMotion for vGPU VMs in VMware Cloud Foundation 9.0, blog de VCF de Broadcom, junio de 2025
- New Tuning Settings for DRS and vMotion for VMs with Virtual GPUs in vSphere 8.0 Update 2, blog de VCF de Broadcom, sept. de 2023
- vSphere Lifecycle Manager is unable to place a host into maintenance mode if it has a running vGPU Virtual Machine, base de conocimientos de Broadcom
- Requirements for Deploying VMware Private AI Foundation with NVIDIA, Broadcom TechDocs
- VMware Private AI Foundation with NVIDIA 9.1, Broadcom TechDocs
- LeftoverLocals: Listening to LLM Responses Through Leaked GPU Local Memory, Trail of Bits
- AMD, Apple, Qualcomm, Imagination GPUs could leak AI secrets via LeftoverLocals, SC Media
- Apple, AMD, Qualcomm GPU security hole lets miscreants snoop on AI training and chats, The Register
- Broadcom bundles private AI into VCF, adds security automation, Computer Weekly
- vGPU Compute Model, VMware Cloud Foundation 9.1 design guide, Broadcom TechDocs
- What's New: vSphere, VMware Cloud Foundation 9.0 release notes, Broadcom TechDocs
- What's New: vSphere, VMware Cloud Foundation 9.1 release notes, Broadcom TechDocs
- vSphere with VCF 9.1 General FAQ, VMware, mayo de 2026
- What's New with vSphere in VMware Cloud Foundation 9.1, blog de VCF de Broadcom, mayo de 2026
- NVIDIA-Certified Hypervisors, NVIDIA
Este artículo trata sobre Aurakore Virtualization.
Ver Aurakore Virtualization