A falácia do kernel compartilhado: por que um pod do Kubernetes não basta para agentes que rodam código
Equipes estão rodando agentes autônomos em pods comuns e tratando esses agentes como microsserviços. Cada um desses pods compartilha um kernel com o resto do node. A solução não é um container mais rígido; é uma fronteira diferente.
Equipes corporativas estão colocando agentes de IA autônomos em pods padrão de Docker e Kubernetes e tratando esses agentes como microsserviços. Isso é uma bomba-relógio arquitetural, porque cada um desses pods compartilha um único kernel com todo o resto do node. A solução não é um container mais rígido. É uma fronteira diferente.
Para ser preciso sobre a afirmação: ela vale para agentes que executam código gerado, rodam comandos de shell ou buscam dependências, e o Kubernetes não é o problema. O problema é o kernel compartilhado embaixo de um pod padrão. Corrija a fronteira e o Kubernetes continua sendo um ótimo orquestrador. Eu construo infraestrutura de virtualização e passei anos vendendo esse tipo de solução, então pese o meu viés de acordo e confira as fontes.
Um agente não é um microsserviço
Um microsserviço é código que a sua equipe escreveu, revisou e empacotou em uma imagem. O comportamento dele é delimitado no momento do build. Um agente autônomo não é nada disso.
| Propriedade | Microsserviço | Agente autônomo |
|---|---|---|
| Código que roda | Revisado, construído e escaneado antes do deploy | Gerado em tempo de execução, muitas vezes há poucos minutos |
| Dependências | Fixadas na imagem | Buscadas sob demanda (pip install, npm install) |
| Acesso ao shell | Quase nunca | Rotina: arquivos, git, ferramentas de build |
| Chamadas de ferramentas | Um conjunto fixo de APIs conhecidas | Servidores MCP e ferramentas escolhidos em tempo de execução |
| Quem decide o que ele faz | Os seus engenheiros | Um modelo lendo texto não confiável |
A última linha é a que importa. Um modelo que lê páginas web, tickets e documentos pode ser conduzido pelo que estiver escrito neles. Trate um agente como um processo cujas instruções podem ser reescritas por um estranho, e o modelo de segurança muda.
Como "é só dar as permissões" vira modo privilegiado
Ninguém começa querendo rodar um agente como root no host. Isso acontece um pedido razoável de cada vez.
- O agente precisa instalar um pacote, então você afrouxa as restrições do sistema de arquivos.
- Ele precisa rodar testes que iniciam containers, então você monta o socket do Docker ou roda Docker-in-Docker.
- As ferramentas de build precisam de capabilities extras, então você as adiciona, ou define o pod como privilegiado para parar de brigar com as mensagens de erro.
- Ele precisa alcançar APIs internas, então a política de rede ganha uma regra de permissão ampla.
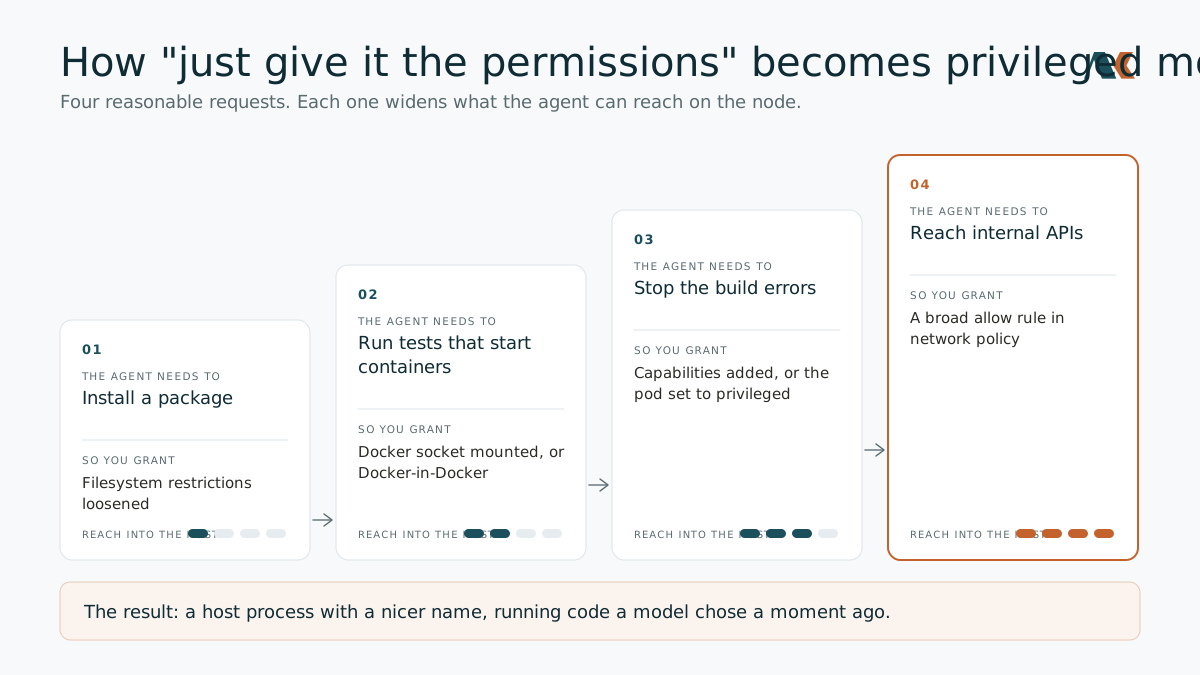
O resultado é um pod com as capabilities necessárias para carregar módulos do kernel ou alcançar o host, rodando um texto que o modelo escolheu um momento atrás.
Um container privilegiado não é uma fronteira entre tenants. É um processo do host com um nome mais bonito, e todos os outros tenants daquele node agora compartilham o destino dele.
O Kubernetes tem proteções exatamente contra isso, e elas merecem crédito. O Pod Security Standard Baseline proíbe pods privilegiados, volumes hostPath (o jeito habitual de montar um socket do Docker), capabilities além de uma lista curta considerada segura e o compartilhamento dos namespaces do host. Desde o Kubernetes 1.36, user namespaces estão em disponibilidade geral: defina hostUsers: false e o root dentro do container é mapeado para um usuário sem privilégios no host. Use os dois. Mas cada etapa da escalada acima é um pedido para desligar um deles, e agentes são a carga de trabalho que continua fazendo esse pedido. Mesmo com todas as proteções ligadas, o kernel continua compartilhado.
O kernel compartilhado é o problema inteiro
Containers são namespaces e cgroups sobre um único kernel Linux. Cada chamada de sistema que um agente faz chega ao mesmo kernel que atende as suas outras cargas de trabalho. Essa fronteira já foi rompida várias vezes, e recentemente. Em janeiro de 2024, o Leaky Vessels (CVE-2024-21626) permitia que um processo de container chegasse ao sistema de arquivos do host por meio de um file descriptor vazado pelo runc, acessível com runc exec ou com uma imagem maliciosa.
Em novembro de 2025, o projeto runc divulgou três falhas de alta severidade de fuga de container (CVE-2025-31133, CVE-2025-52565 e CVE-2025-52881). São condições de corrida na forma como o runc lida com montagens e escritas em /proc durante a inicialização do container. A visão técnica da CNCF observa que elas podem ser disparadas por configurações de montagem personalizadas, inclusive as definidas em um Dockerfile, e uma delas (CVE-2025-52881) pode anular a rotulagem de módulos de segurança do Linux, o que deixa processos confinados pelo AppArmor sem confinamento. As versões afetadas incluíam praticamente todas as releases até as correções no runc 1.2.8, 1.3.3 e 1.4.0-rc.3.
Agora coloque isso ao lado do comportamento de um agente, com uma precisão. Essas falhas exigem a capacidade de iniciar containers com uma imagem ou configurações de montagem escolhidas, e rodar um build basta. Então um agente confinado a um pod comum só fica exposto se puder rodar builds, publicar imagens ou moldar specs de pods. O perigo aparece quando você dá a ele esses meios: um socket do Docker montado, Docker-in-Docker ou nodes de build compartilhados. Agentes pedem exatamente isso, porque construir imagens e rodar Dockerfiles faz parte do trabalho. Esses bugs específicos já foram corrigidos. A lição é a classe: fugas pelo runtime e pelo kernel continuam aparecendo, e uma plataforma que deixa agentes iniciarem containers está apostando que vai aplicar correções mais rápido do que alguém tenta explorar.
A camada de ferramentas acrescenta mais. Um levantamento de segurança contabiliza cerca de 30 CVEs registrados contra servidores MCP em menos de 60 dias a partir de janeiro de 2026, com injeção de comandos entre as falhas mais comuns. Trate o número exato como indicativo, já que é uma contagem secundária. O padrão é fácil de entender: um servidor MCP que passa para um shell uma entrada fornecida pelo modelo transformou um prompt em um comando. A partir daí, o caminho mais curto até o dano costuma passar pelo que as credenciais e a rede desse servidor conseguem alcançar. O caminho mais longo passa pelo kernel: se o servidor divide um node com o seu serviço de pagamentos, uma fuga pelo runtime ou pelo kernel transforma uma única string elaborada em um dia muito ruim. Uma microVM fecha o segundo caminho, não o primeiro, e é por isso que os controles de credenciais e de saída descritos abaixo importam tanto quanto a fronteira.
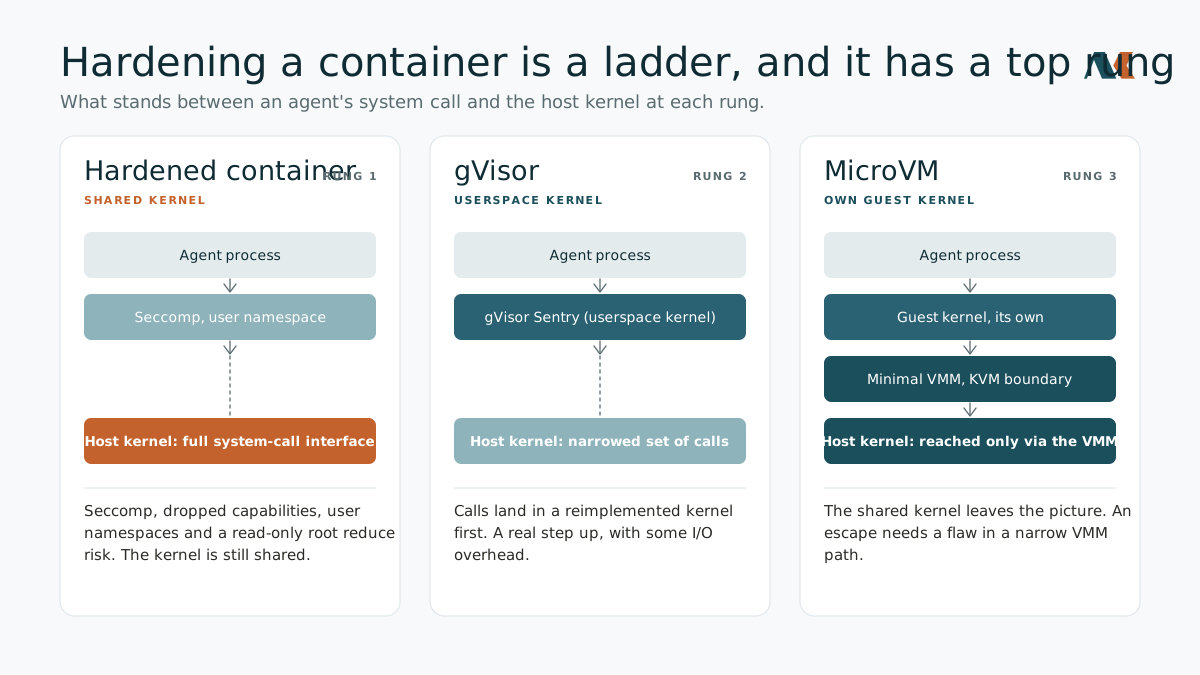
Endurecer um container é uma escada, e ela tem um último degrau
As equipes de segurança têm opções, e vale ser honesto sobre elas.
- Containers comuns com perfis mais restritos. Seccomp, capabilities removidas, raízes somente leitura e user namespaces reduzem o risco. O kernel continua compartilhado.
- gVisor. Um kernel em espaço de usuário intercepta as chamadas de sistema, então a aplicação conversa com uma reimplementação em vez do kernel do host. Um avanço real, com algum overhead de I/O (um guia prático estima algo entre 10 e 30 por cento em trabalhos com muito I/O).
- MicroVMs isoladas por hardware. Cada carga de trabalho ganha o próprio kernel convidado atrás de uma fronteira KVM imposta pela CPU.
A comunidade Kubernetes percebeu. O SIG Apps lançou o projeto Agent Sandbox na KubeCon North America em novembro de 2025: um custom resource Sandbox para runtimes de agentes isolados, com estado e de instância única, apoiado em gVisor ou Kata Containers, com pools aquecidos para trazer a inicialização para menos de um segundo. É um sinal forte de que o pod padrão não é considerado suficiente para agentes.
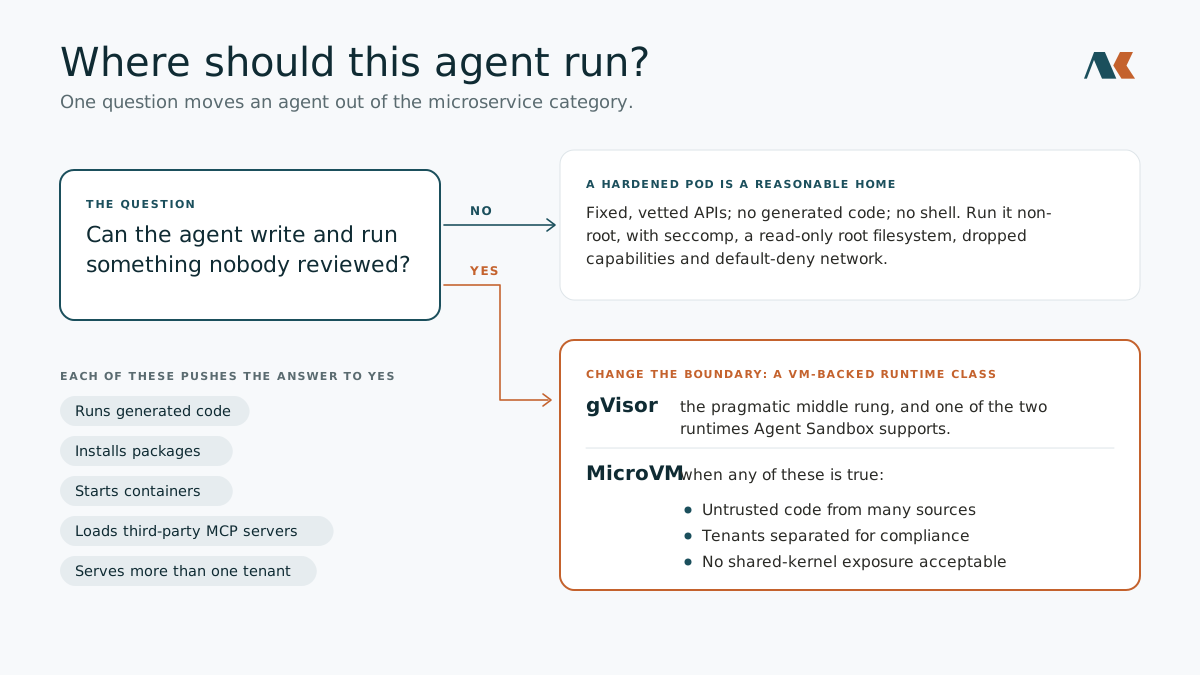
Os degraus diferem em natureza, não só em grau. O gVisor estreita o que um processo hostil consegue alcançar no kernel do host. Uma microVM tira o kernel compartilhado de cena. Para muitas equipes, o gVisor é o degrau intermediário pragmático, e ele é um dos dois runtimes que o Agent Sandbox suporta. Escolha uma microVM quando agentes rodam código não confiável de muitas origens, quando os tenants precisam ser separados por exigência de compliance ou quando você não pode aceitar nenhuma exposição a kernel compartilhado.
Quando um container ainda serve
Nem todo agente precisa de uma microVM. Um agente que chama um conjunto fixo de APIs avaliadas, não roda código gerado e não tem shell está muito mais perto de um microsserviço. Um pod endurecido (sem root, seccomp, sistema de arquivos raiz somente leitura, capabilities removidas, rede negada por padrão) é um lugar razoável para ele.
O risco sobe a cada capacidade que você adiciona: rodar código gerado, instalar pacotes, iniciar containers, carregar servidores MCP de terceiros ou atender mais de um tenant. Uma regra útil: no momento em que um agente pode escrever e rodar algo que você não revisou, ele saiu da categoria de microsserviço, e a fronteira deve mudar junto.
Por que microVMs combinam com a forma como agentes realmente trabalham
O argumento se apoia em quatro propriedades.
1. Privilégio deixa de assustar. Dentro de uma microVM, o agente pode ser root, instalar qualquer coisa e rodar Docker, porque o kernel convidado é dele. Um agente "privilegiado" tem privilégio sobre uma máquina descartável, não sobre o seu node. Essa é a propriedade que resolve a armadilha das permissões descrita acima: você pode dizer sim ao agente sem dizer sim ao host.
2. A superfície de ataque é pequena e diferente. Um container consegue alcançar toda a interface de chamadas de sistema do kernel do host. Um convidado de microVM alcança um monitor de máquina virtual mínimo. O Firecracker, o VMM construído pela AWS por trás do Lambda e do Fargate, é escrito em Rust, emula uma lista deliberadamente curta de dispositivos e vem com um jailer que envolve o VMM no próprio chroot, namespaces e cgroups, enquanto o próprio Firecracker aplica filtros seccomp por thread. Uma fuga agora exige uma falha nesse caminho estreito, em vez de em qualquer uma das várias centenas de chamadas de sistema do kernel do host.
3. É rápida o bastante para ser descartável. O Firecracker documenta inicialização em espaço de usuário em cerca de 125 milissegundos, menos de 5 MiB de overhead de memória por microVM e taxas de criação de até 150 por segundo por host. Esse número é o tempo até o init do convidado, então o runtime do agente e os pacotes somam a ele. Ainda assim, uma inicialização medida em frações de segundo é o que torna uma microVM por tarefa algo prático em vez de uma aspiração.
4. Desmontar é uma fronteira, não um script de limpeza. O que nos leva aos resíduos.
Descartável por design: nenhum resíduo de credenciais
Pods de longa duração acumulam segredos. Tokens ficam em variáveis de ambiente, histórico do shell, caches do gerenciador de pacotes, diretórios temporários e swap. Um container "limpo" reutilizado na tarefa seguinte pode entregar a ela as chaves da tarefa anterior.
Uma microVM efêmera muda o padrão:
- Uma tarefa, uma máquina. O disco gravável e a memória do convidado são descartados quando a tarefa termina. Não há nada a apagar dentro do convidado, embora tudo o que você montou nele ou enviou para fora continue sendo responsabilidade sua.
- Os segredos ficam do lado de fora. Siga o padrão que o Google Cloud descreve para o Agent Compute Engine, anunciado em outubro de 2026 e previsto para preview: credenciais de longa duração nunca entram no sandbox, e um gateway injeta o acesso em nome do agente. Um convidado comprometido não consegue levar as credenciais embora, mas durante a sessão ainda pode usar qualquer acesso que o gateway conceda, então limite o escopo e o orçamento desse acesso com rigor.
- Saída negada por padrão. O sandbox só alcança os destinos que você listou, então uma ferramenta envenenada não consegue se comunicar com quem a controla.
- Trate snapshots como sensíveis. Snapshot e restore deixam os pools aquecidos rápidos, mas um snapshot captura a memória. Guarde-o com o mesmo cuidado dos segredos que podem estar nele. Restaurar muitas microVMs a partir de um único snapshot também copia um estado que deveria ser único: a documentação do Firecracker alerta que identificadores, números aleatórios e tokens criptográficos podem acabar sendo usados duas vezes, e o VMGenID só renova a entropia do kernel convidado. Dê a cada clone a própria identidade e as próprias chaves depois do restore.
Uma ressalva da literatura sobre sandboxing merece ser repetida: o isolamento contém a execução, não o propósito. Um agente autorizado a enviar dados para um destino aprovado ainda pode enviar os dados errados. A fronteira do kernel é o piso. Identidade, política e auditoria ficam por cima dela.
O que as microVMs custam
O argumento é forte, não gratuito.
- Não são inquebráveis. Hypervisors e VMMs também tiveram bugs de fuga, incluindo uma fuga de convidado para host no qemu-kvm publicada em 2011 (Virtunoid, CVE-2011-1751). A afirmação é uma superfície de ataque muito menor somada a defesa em profundidade, não risco zero.
- Elas precisam de KVM. Isso significa bare metal ou virtualização aninhada, que nem todo tipo de instância de nuvem oferece e que pode custar desempenho.
- A inicialização tem camadas. O número de 125 milissegundos cobre levar o convidado até o init. O runtime do agente e as dependências vêm depois, e é por isso que pools aquecidos e snapshots importam.
- Algumas coisas ficam mais difíceis. Acesso a GPU, sistemas de arquivos compartilhados e observabilidade detalhada exigem mais design do que em um pod comum.
O Kubernetes pode ficar
Nada disso exige abandonar o seu cluster. O Kata Containers roda cada pod dentro da própria VM leve, usando QEMU, Cloud Hypervisor, Firecracker ou Dragonball, entre outros, enquanto apresenta a API normal do Kubernetes. O Agent Sandbox escolhe a camada de isolamento por meio de uma runtime class. Você pode manter o agendamento, a rede, a observabilidade e o RBAC, e mudar o que fica embaixo do pod.
O princípio de design é simples: orquestre com Kubernetes, isole com hardware.
O que fazer antes que os seus agentes cheguem à produção
- Encontre os pods privilegiados. Procure privileged: true, sockets do Docker montados, capabilities adicionadas e volumes hostPath em qualquer namespace que rode agentes. Cada um deles é um achado.
- Mova as cargas de trabalho de agentes para uma runtime class apoiada em VM. Kata ou um sandbox baseado em microVM, não o runtime padrão.
- Uma tarefa de agente por sandbox, destruído no final. Nada de reutilização entre tenants ou tarefas.
- Mantenha as credenciais fora do convidado. Use um padrão de acesso intermediado e tokens de curta duração.
- Aplique o Pod Security nos namespaces de agentes. Baseline no mínimo, Restricted onde for possível, para que toda exceção privilegiada seja uma decisão visível e revisada.
- Ligue user namespaces onde o runtime suportar. Com hostUsers: false, root no container não é root no host.
- Aplique as correções do runtime mesmo assim. Confira se os nodes rodam uma versão corrigida do runc, já que a defesa em profundidade ainda inclui a camada de kernel compartilhado para todo o resto que você roda.
- Registre na fronteira. Registre o que cada sandbox iniciou, alcançou e escreveu, de forma à prova de adulteração, para que você possa reconstruir uma sessão.
A conclusão
Containers foram projetados para empacotar software em que a sua equipe confia. Agentes autônomos são software que decide o que rodar depois de ser entregue. Colocar os que rodam código que ninguém revisou no mesmo kernel dos seus serviços de produção é um erro de categoria, por mais bem configurado que o pod esteja.
A infraestrutura que lida bem com agentes vai se parecer menos com um host Docker maior e mais com uma frota de máquinas virtuais pequenas e descartáveis, iniciadas em uma fração de segundo e eliminadas quando a tarefa termina. Os hypervisors passaram duas décadas aprendendo a manter cargas de trabalho hostis separadas. Os agentes são o motivo para usar essa lição de novo.
Perguntas frequentes
O que é um container? É uma forma de empacotar uma aplicação e rodá-la isolada das outras aplicações no mesmo servidor. Containers são leves e rápidos porque todos tomam emprestado o mesmo núcleo do sistema operacional.
O que é um kernel, e o que significa "kernel compartilhado"? O kernel é o núcleo do sistema operacional, a parte que controla a memória, os arquivos e o hardware. Os containers de um servidor compartilham um único kernel, então uma falha nele pode expor todos os containers daquele servidor.
O que é uma microVM? É uma máquina virtual muito pequena, com o próprio kernel, iniciada em uma fração de segundo. Como o kernel não é compartilhado, um problema dentro dela fica dentro dela.
O que significa "privilegiado" para um container? Significa que o container recebe poderes próximos aos do próprio host. Um container privilegiado deixa de ser uma fronteira segura entre tenants, e é por isso que concedê-lo a um agente é arriscado.
O que é um servidor MCP? O Model Context Protocol é uma forma padronizada de um agente de IA usar ferramentas externas, como um banco de dados ou um sistema de tickets. Um servidor MCP é o programa que expõe uma dessas ferramentas ao agente.
O Pod Security do Kubernetes não basta? Ele bloqueia pods privilegiados, montagens do host e capabilities extras, e deve estar ligado em todo namespace que rode agentes. Ele não muda o que fica embaixo: um agente em um pod totalmente em conformidade ainda compartilha o kernel do node com todo o resto.
O que são user namespaces? Um recurso do Linux, em disponibilidade geral no Kubernetes desde a versão 1.36, que mapeia o root dentro de um container para um usuário comum no host. Ele limita o que uma fuga consegue fazer, mas o kernel continua compartilhado.
O que é o gVisor? Um kernel escrito em espaço de usuário que fica entre um container e o kernel do host e responde ele mesmo à maioria das chamadas de sistema. Ele estreita o que chega ao kernel do host, com algum custo em desempenho de I/O.
Eu tenho que abrir mão do Kubernetes? Não. O Kubernetes pode continuar agendando e gerenciando as suas cargas de trabalho enquanto um runtime baseado em VM, como o Kata Containers, fornece o isolamento por baixo. A mudança está no que fica embaixo do pod, não em como você opera o cluster.
Todo agente de IA precisa de uma microVM? Não. Um agente que só chama um conjunto fixo de APIs avaliadas e não roda código gerado está muito mais perto de um serviço comum, e um container endurecido pode bastar para ele. O risco sobe quando o agente pode escrever e rodar coisas que ninguém revisou.
O que é o Kata Containers? Um runtime open source que roda cada pod do Kubernetes dentro da própria máquina virtual leve, usando um hypervisor como QEMU, Cloud Hypervisor, Firecracker ou Dragonball. O cluster continua vendo um pod comum.
O que é o Firecracker? Um monitor de máquina virtual open source construído pela AWS e usado por trás do Lambda e do Fargate. A documentação dele indica uma inicialização até o init do convidado em cerca de 125 milissegundos, com menos de 5 MiB de overhead de memória por microVM.
O que é o Agent Sandbox? Um projeto do SIG Apps do Kubernetes lançado em novembro de 2025. Ele adiciona um recurso Sandbox para runtimes de agentes isolados e com estado, apoiado em gVisor ou Kata Containers, com pools aquecidos que trazem a inicialização para menos de um segundo.
Como encontro pods de agentes arriscados no meu cluster? Procure privileged: true, sockets do Docker montados, capabilities adicionadas e volumes hostPath em qualquer namespace que rode agentes. Aplicar o Pod Security Standard Baseline transforma cada um deles em um pedido rejeitado ou em uma exceção revisada.
Uma microVM impede prompt injection? Não. Ela limita o que um agente sequestrado consegue alcançar no host, mas um agente autorizado a chamar uma ferramenta ou um destino aprovado ainda pode ser conduzido a usá-los de forma indevida. Credenciais mantidas fora do sandbox, tráfego de saída negado por padrão e registro na fronteira cuidam do resto.
MicroVMs custam mais para rodar? Elas precisam de KVM, o que significa bare metal ou virtualização aninhada, e cada sandbox acrescenta algum overhead de memória e de inicialização. Pools aquecidos e snapshots reduzem o tempo de inicialização, mas cada clone restaurado precisa da própria identidade e das próprias chaves.
Cheick M Ouedraogo passou cerca de oito anos em vendas de tecnologia corporativa, incluindo VMware e Broadcom, antes de fundar a Aurakore, onde constrói infraestrutura de virtualização e de IA privada. Ele escreve sobre o que os compradores devem perguntar e sobre o que a documentação realmente diz.
Fontes
- runc container breakout vulnerabilities: a technical overview, CNCF, nov. 2025
- runc security advisory GHSA-cgrx-mc8f-2prm (CVE-2025-52881), projeto runc
- runc security advisory GHSA-xr7r-f8xq-vfvv (CVE-2024-21626), projeto runc, jan. 2024
- Kubernetes v1.36: User Namespaces in Kubernetes are finally GA, blog do Kubernetes, abr. 2026
- Pod Security Standards, documentação do Kubernetes
- Firecracker snapshot support, projeto Firecracker
- New runc vulnerabilities allow container escape, Sysdig, nov. 2025
- Running Agents on Kubernetes with Agent Sandbox, blog do Kubernetes, mar. 2026
- Unleashing autonomous AI agents: why Kubernetes needs a new standard for agent execution, Google Open Source Blog, nov. 2025
- Kubernetes Agent Sandbox guide, Pulumi
- AI Agent Sandboxing Explained: Why Docker Is Not Enough, SoftwareSeni
- Firecracker, secure and fast microVMs, projeto Firecracker
- Firecracker: lightweight virtualization for serverless, LWN.net
- MCP Security: 30 CVEs in 60 Days, Noqta
- MCP Security Vulnerabilities: Complete Threat Inventory, Obsidian Security
- Agent Compute Engine deep dive, blog do Google Cloud, out. 2026
- AI Agent Sandboxing, Prediction Guard, atualizado em ago. 2026
Este artigo é sobre Aurakore Virtualization.
Conheça Aurakore Virtualization