L'illusion du noyau partagé : pourquoi un pod Kubernetes ne suffit pas pour les agents qui exécutent du code
Des équipes font tourner des agents autonomes dans des pods ordinaires et les traitent comme des microservices. Chacun de ces pods partage un noyau avec le reste du nœud. La solution n'est pas un conteneur plus durci ; c'est une autre frontière.
Des équipes d'entreprise déposent des agents d'IA autonomes dans des pods Docker et Kubernetes standard et les traitent comme des microservices. C'est une bombe à retardement architecturale, car chacun de ces pods partage un seul noyau avec tout le reste du nœud. La solution n'est pas un conteneur plus durci. C'est une autre frontière.
Pour être précis sur l'affirmation : elle concerne les agents qui exécutent du code généré, lancent des commandes shell ou récupèrent des dépendances, et Kubernetes n'est pas le problème. Le noyau partagé sous un pod par défaut l'est. Corrigez la frontière et Kubernetes reste un excellent orchestrateur. Je construis de l'infrastructure de virtualisation et j'ai passé des années à la vendre, alors tenez compte de mon parti pris et consultez les sources.
Un agent n'est pas un microservice
Un microservice, c'est du code que votre équipe a écrit, relu et intégré dans une image. Son comportement est borné au moment du build. Un agent autonome n'est rien de tout cela.
| Propriété | Microservice | Agent autonome |
|---|---|---|
| Code exécuté | Relu, construit, analysé avant le déploiement | Généré à l'exécution, souvent quelques minutes plus tôt |
| Dépendances | Figées dans l'image | Récupérées à la demande (pip install, npm install) |
| Accès shell | Presque jamais | Routinier : fichiers, git, outils de build |
| Appels d'outils | Un ensemble fixe d'API connues | Serveurs MCP et outils choisis à l'exécution |
| Qui décide de ce qu'il fait | Vos ingénieurs | Un modèle qui lit du texte non fiable |
C'est la dernière ligne qui compte. Un modèle qui lit des pages web, des tickets et des documents peut être orienté par tout ce qui y est écrit. Traitez un agent comme un processus dont les instructions peuvent être réécrites par un inconnu, et le modèle de sécurité change.
Comment « donnez-lui simplement les permissions » devient le mode privilégié
Personne ne décide de faire tourner un agent en root sur l'hôte. Cela arrive une demande raisonnable à la fois.
- L'agent doit installer un paquet, alors vous assouplissez les restrictions du système de fichiers.
- Il doit lancer des tests qui démarrent des conteneurs, alors vous montez le socket Docker ou utilisez Docker-in-Docker.
- Les outils de build ont besoin de capabilities supplémentaires, alors vous les ajoutez, ou vous passez le pod en privileged pour ne plus vous battre avec les messages d'erreur.
- Il doit atteindre des API internes, alors la politique réseau reçoit une règle d'autorisation large.
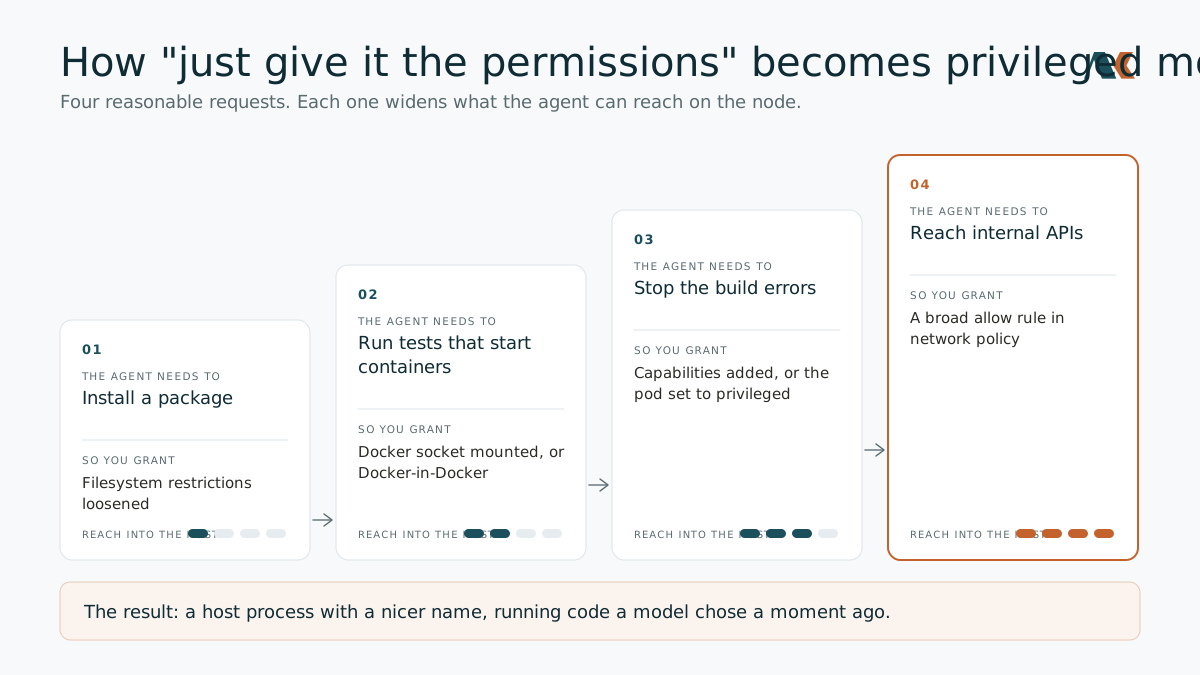
Le résultat est un pod qui dispose des capabilities nécessaires pour charger des modules du noyau ou atteindre l'hôte, et qui exécute un texte que le modèle a choisi un instant plus tôt.
Un conteneur privilégié n'est pas une frontière entre locataires. C'est un processus de l'hôte avec un nom plus flatteur, et tous les autres locataires de ce nœud partagent désormais son sort.
Kubernetes dispose de garde-fous contre exactement cela, et ils méritent d'être reconnus. Le Pod Security Standard Baseline interdit les pods privilégiés, les volumes hostPath (la façon habituelle de monter un socket Docker), les capabilities au-delà d'une courte liste sûre, et le partage des namespaces de l'hôte. Depuis Kubernetes 1.36, les user namespaces sont en disponibilité générale : définissez hostUsers: false et le root dans le conteneur correspond à un utilisateur non privilégié sur l'hôte. Utilisez les deux. Mais chaque étape de la dérive ci-dessus est une demande pour désactiver l'un d'eux, et les agents sont la charge de travail qui ne cesse de la formuler. Même avec tous les garde-fous activés, le noyau reste partagé.
Le noyau partagé est tout le problème
Les conteneurs sont des namespaces et des cgroups au-dessus d'un seul noyau Linux. Chaque appel système d'un agent aboutit dans le même noyau qui sert vos autres charges de travail. Cette frontière a été franchie à plusieurs reprises, et récemment. En janvier 2024, Leaky Vessels (CVE-2024-21626) permettait à un processus de conteneur d'atterrir dans le système de fichiers de l'hôte grâce à un descripteur de fichier laissé ouvert par runc, accessible avec runc exec ou une image malveillante.
En novembre 2025, le projet runc a divulgué trois failles d'évasion de conteneur de gravité élevée (CVE-2025-31133, CVE-2025-52565 et CVE-2025-52881). Ce sont des situations de concurrence dans la façon dont runc gère les montages et les écritures dans /proc au démarrage d'un conteneur. La présentation technique de la CNCF note qu'elles peuvent être déclenchées par des configurations de montage personnalisées, y compris celles définies dans un Dockerfile, et que l'une d'elles (CVE-2025-52881) peut neutraliser l'étiquetage des modules de sécurité Linux, ce qui laisse sans confinement des processus confinés par AppArmor. Les versions concernées incluaient pratiquement toutes les publications jusqu'aux correctifs de runc 1.2.8, 1.3.3 et 1.4.0-rc.3.
Placez maintenant cela à côté du comportement des agents, avec une précision. Ces failles exigent de pouvoir démarrer des conteneurs avec une image ou des paramètres de montage choisis, et lancer un build suffit. Un agent confiné dans un pod ordinaire n'est donc exposé que s'il peut lancer des builds, pousser des images ou façonner des spécifications de pod. Le danger apparaît quand vous lui en donnez les moyens : un socket Docker monté, Docker-in-Docker ou des nœuds de build partagés. Les agents demandent exactement cela, car construire des images et exécuter des Dockerfiles fait partie du travail. Ces bugs précis sont corrigés. La leçon porte sur la catégorie : les évasions par le runtime et le noyau continuent d'apparaître, et une plateforme qui laisse les agents démarrer des conteneurs parie qu'elle appliquera les correctifs plus vite que quelqu'un ne tentera sa chance.
La couche des outils en ajoute. Une analyse de sécurité dénombre environ 30 CVE déposées contre des serveurs MCP en moins de 60 jours à partir de janvier 2026, l'injection de commandes figurant parmi les failles les plus courantes. Considérez le chiffre exact comme indicatif, car il s'agit d'un décompte secondaire. Le schéma est facile à comprendre : un serveur MCP qui transmet à un shell une entrée fournie par le modèle a transformé un prompt en commande. À partir de là, le chemin le plus court vers des dégâts passe généralement par tout ce que les identifiants et le réseau de ce serveur peuvent atteindre. Le chemin le plus long passe par le noyau : si le serveur partage un nœud avec votre service de paiement, une évasion par le runtime ou le noyau transforme une seule chaîne forgée en très mauvaise journée. Une microVM ferme le second chemin, pas le premier, et c'est pourquoi les contrôles d'identifiants et de sortie réseau décrits plus bas comptent autant que la frontière.
Durcir un conteneur est une échelle, et elle a un dernier barreau
Les équipes de sécurité ont bien des options, et il faut en parler honnêtement.
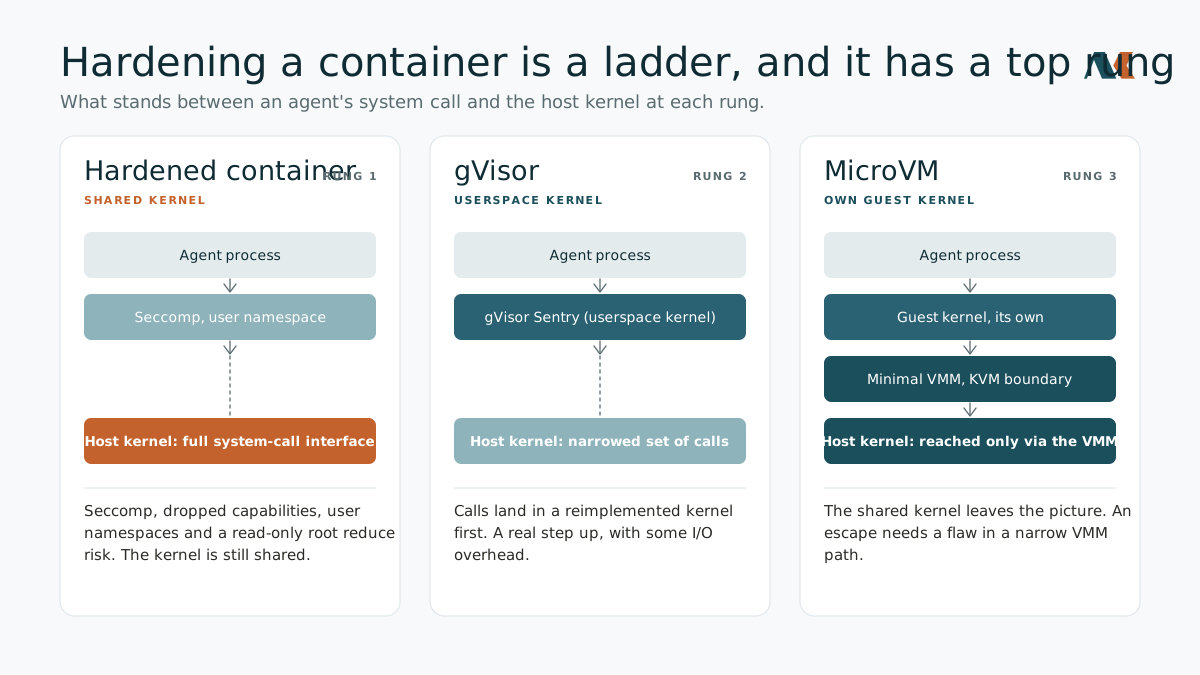
- Des conteneurs simples avec des profils resserrés. Seccomp, capabilities retirées, racines en lecture seule et user namespaces réduisent le risque. Le noyau reste partagé.
- gVisor. Un noyau en espace utilisateur intercepte les appels système, de sorte que l'application dialogue avec une réimplémentation plutôt qu'avec le noyau de l'hôte. Un vrai progrès, avec un certain surcoût en I/O (un guide de praticien l'estime à environ 10 à 30 pour cent sur les charges intensives en I/O).
- Des microVM isolées par le matériel. Chaque charge de travail reçoit son propre noyau invité derrière une frontière KVM imposée par le processeur.
La communauté Kubernetes l'a remarqué. SIG Apps a lancé le projet Agent Sandbox à la KubeCon North America en novembre 2025 : une ressource personnalisée Sandbox pour des runtimes d'agents isolés, avec état et à instance unique, reposant sur gVisor ou Kata Containers, avec des pools préchauffés pour ramener le démarrage sous la seconde. C'est un signal fort que le pod par défaut n'est pas jugé suffisant pour les agents.
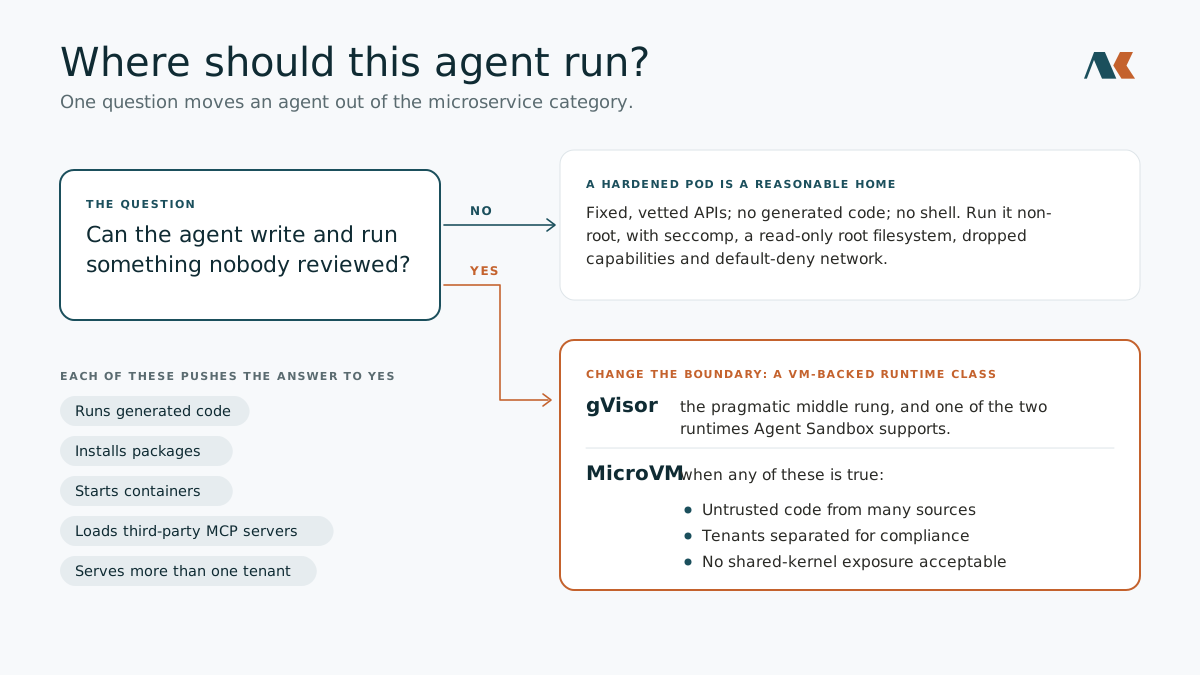
Les barreaux diffèrent par nature, pas seulement par degré. gVisor restreint ce qu'un processus hostile peut atteindre dans le noyau de l'hôte. Une microVM retire le noyau partagé de l'équation. Pour beaucoup d'équipes, gVisor est le barreau intermédiaire pragmatique, et c'est l'un des deux runtimes pris en charge par Agent Sandbox. Choisissez une microVM quand des agents exécutent du code non fiable provenant de nombreuses sources, quand des locataires doivent être séparés pour des raisons de conformité, ou quand vous ne pouvez accepter aucune exposition au noyau partagé.
Quand un conteneur suffit encore
Tous les agents n'ont pas besoin d'une microVM. Un agent qui appelle un ensemble fixe d'API contrôlées, n'exécute aucun code généré et n'a pas de shell est bien plus proche d'un microservice. Un pod durci (non-root, seccomp, système de fichiers racine en lecture seule, capabilities retirées, réseau refusé par défaut) est un hébergement raisonnable pour lui.
Le risque augmente avec chaque capacité ajoutée : exécuter du code généré, installer des paquets, démarrer des conteneurs, charger des serveurs MCP tiers, ou servir plus d'un locataire. Une règle utile : dès qu'un agent peut écrire et exécuter quelque chose que vous n'avez pas relu, il a quitté la catégorie des microservices, et la frontière doit changer avec lui.
Pourquoi les microVM correspondent à la façon dont les agents travaillent réellement
L'argument repose sur quatre propriétés.
1. Le privilège cesse d'être inquiétant. Dans une microVM, l'agent peut être root, tout installer et exécuter Docker, car le noyau invité lui appartient. Un agent « privilégié » détient des privilèges sur une machine jetable, pas sur votre nœud. C'est la propriété qui résout le piège des permissions décrit plus haut : vous pouvez dire oui à l'agent sans dire oui à l'hôte.
2. La surface d'attaque est réduite et différente. Un conteneur peut atteindre toute l'interface d'appels système du noyau de l'hôte. Un invité de microVM atteint un moniteur de machine virtuelle minimal. Firecracker, le VMM conçu par AWS qui fait tourner Lambda et Fargate, est écrit en Rust, émule une liste volontairement courte de périphériques et fournit un jailer qui enveloppe le VMM dans son propre chroot, ses namespaces et ses cgroups, tandis que Firecracker applique lui-même des filtres seccomp par thread. Une évasion exige désormais une faille dans ce chemin étroit, plutôt que dans n'importe lequel des quelques centaines d'appels système du noyau de l'hôte.
3. C'est assez rapide pour être jetable. Firecracker documente un démarrage de l'espace utilisateur en environ 125 millisecondes, moins de 5 MiB de surcoût mémoire par microVM, et des cadences de création allant jusqu'à 150 par seconde et par hôte. Ce chiffre correspond au temps jusqu'à l'init de l'invité, donc le runtime de l'agent et ses paquets s'y ajoutent. Malgré tout, un démarrage mesuré en fractions de seconde est ce qui rend une microVM par tâche réaliste plutôt que théorique.
4. La destruction est une frontière, pas un script de nettoyage. Ce qui nous amène aux résidus.
Jetable par conception : aucun résidu d'identifiants
Les pods à longue durée de vie accumulent des secrets. Des jetons restent dans les variables d'environnement, l'historique du shell, les caches des gestionnaires de paquets, les répertoires temporaires et le swap. Un conteneur « propre » réutilisé pour la tâche suivante peut remettre à cette tâche les clés de la précédente.
Une microVM éphémère change le comportement par défaut :
- Une tâche, une machine. Le disque inscriptible et la mémoire de l'invité sont détruits à la fin de la tâche. Il n'y a rien à effacer dans l'invité, même si tout ce que vous y avez monté ou envoyé à l'extérieur reste sous votre responsabilité.
- Les secrets restent à l'extérieur. Suivez le schéma que Google Cloud décrit pour Agent Compute Engine, annoncé en octobre 2026 et prévu en préversion : les identifiants à longue durée de vie n'entrent jamais dans le sandbox, et une passerelle injecte l'accès pour le compte de l'agent. Un invité compromis ne peut pas emporter les identifiants, mais pendant la session il peut toujours utiliser l'accès que la passerelle accorde, alors délimitez et plafonnez strictement cet accès.
- Sortie réseau refusée par défaut. Le sandbox n'atteint que les destinations que vous avez listées, de sorte qu'un outil empoisonné ne peut pas joindre son commanditaire.
- Traitez les snapshots comme sensibles. Le snapshot et la restauration rendent les pools préchauffés rapides, mais un snapshot capture la mémoire. Stockez-le avec le même soin que les secrets qu'il pourrait contenir. Restaurer de nombreuses microVM à partir d'un seul snapshot copie aussi un état censé être unique : la documentation de Firecracker avertit que des identifiants, des nombres aléatoires et des jetons cryptographiques peuvent finir utilisés deux fois, et VMGenID ne réensemence que l'entropie du noyau invité. Donnez à chaque clone sa propre identité et ses propres clés après la restauration.
Une réserve tirée de la littérature sur le sandboxing mérite d'être répétée : l'isolation contient l'exécution, pas la finalité. Un agent autorisé à envoyer des données vers une destination approuvée peut toujours envoyer les mauvaises données. La frontière du noyau est le socle. L'identité, la politique et l'audit reposent dessus.
Ce que coûtent les microVM
L'argument est solide, pas gratuit.
- Pas inviolables. Les hyperviseurs et les VMM ont eux aussi connu des bugs d'évasion, dont une évasion de l'invité vers l'hôte dans qemu-kvm publiée en 2011 (Virtunoid, CVE-2011-1751). L'affirmation porte sur une surface d'attaque bien plus réduite et une défense en profondeur, pas sur un risque nul.
- Elles exigent KVM. Cela signifie du bare metal ou de la virtualisation imbriquée, que tous les types d'instances cloud ne proposent pas et qui peut coûter en performances.
- Le démarrage a plusieurs couches. Le chiffre de 125 millisecondes couvre l'arrivée de l'invité à l'init. Le runtime de l'agent et ses dépendances viennent ensuite, c'est pourquoi les pools préchauffés et les snapshots comptent.
- Certaines choses sont plus difficiles. L'accès GPU, les systèmes de fichiers partagés et l'observabilité fine demandent plus de conception que dans un pod simple.
Kubernetes peut rester
Rien de tout cela n'oblige à abandonner votre cluster. Kata Containers exécute chaque pod dans sa propre VM légère, en utilisant entre autres QEMU, Cloud Hypervisor, Firecracker ou Dragonball, tout en présentant l'API Kubernetes habituelle. Agent Sandbox choisit la couche d'isolation au moyen d'une runtime class. Vous pouvez conserver l'ordonnancement, le réseau, l'observabilité et le RBAC, et changer ce qui se trouve sous le pod.
Le principe de conception est simple : orchestrer avec Kubernetes, isoler avec le matériel.
Ce qu'il faut faire avant que vos agents n'atteignent la production
- Trouvez les pods privilégiés. Recherchez privileged: true, les sockets Docker montés, les capabilities ajoutées et les volumes hostPath dans tout namespace qui exécute des agents. Chacun est une constatation.
- Déplacez les charges de travail des agents vers une runtime class adossée à une VM. Kata ou un sandbox basé sur des microVM, pas le runtime par défaut.
- Une tâche d'agent par sandbox, détruit à la fin. Aucune réutilisation entre locataires ou entre tâches.
- Gardez les identifiants hors de l'invité. Utilisez un schéma d'accès par intermédiaire et des jetons de courte durée.
- Appliquez Pod Security dans les namespaces des agents. Baseline au minimum, Restricted là où c'est possible, pour que chaque exception privilégiée soit une décision visible et relue.
- Activez les user namespaces là où le runtime les prend en charge. Avec hostUsers: false, le root dans le conteneur n'est pas root sur l'hôte.
- Corrigez quand même le runtime. Contrôlez que les nœuds exécutent une version corrigée de runc, car la défense en profondeur inclut toujours la couche du noyau partagé pour tout ce que vous exécutez par ailleurs.
- Journalisez à la frontière. Enregistrez ce que chaque sandbox a démarré, atteint et écrit, de façon à rendre toute altération détectable, pour pouvoir reconstituer une session.
À retenir
Les conteneurs ont été conçus pour empaqueter des logiciels auxquels votre équipe fait confiance. Les agents autonomes sont des logiciels qui décident de ce qu'ils exécutent après leur livraison. Placer ceux qui exécutent du code que personne n'a relu dans le même noyau que vos services de production est une erreur de catégorie, aussi bien configuré que soit le pod.
L'infrastructure qui gère bien les agents ressemblera moins à un hôte Docker plus gros qu'à une flotte de petites machines virtuelles jetables, démarrées en une fraction de seconde et disparues à la fin de la tâche. Les hyperviseurs ont passé deux décennies à apprendre à tenir à l'écart des charges de travail hostiles. Les agents sont la raison d'appliquer à nouveau cette leçon.
Questions fréquentes
Qu'est-ce qu'un conteneur ? C'est une façon d'empaqueter une application et de l'exécuter isolée des autres applications sur le même serveur. Les conteneurs sont légers et rapides parce qu'ils empruntent tous le même cœur du système d'exploitation.
Qu'est-ce qu'un noyau, et que signifie « noyau partagé » ? Le noyau est le cœur du système d'exploitation, la partie qui gère la mémoire, les fichiers et le matériel. Les conteneurs d'un même serveur partagent un seul noyau, si bien qu'une faille dans ce noyau peut exposer tous les conteneurs de ce serveur.
Qu'est-ce qu'une microVM ? C'est une très petite machine virtuelle dotée de son propre noyau, démarrée en une fraction de seconde. Comme le noyau n'est pas partagé, un problème à l'intérieur reste à l'intérieur.
Que signifie « privilégié » pour un conteneur ? Cela signifie que le conteneur reçoit des pouvoirs proches de ceux de l'hôte lui-même. Un conteneur privilégié n'est plus une frontière sûre entre locataires, et c'est pourquoi accorder ce mode à un agent est risqué.
Qu'est-ce qu'un serveur MCP ? Le Model Context Protocol est une façon standard pour un agent d'IA d'utiliser des outils externes, comme une base de données ou un système de tickets. Un serveur MCP est le programme qui expose l'un de ces outils à l'agent.
Pod Security de Kubernetes ne suffit-il pas ? Il bloque les pods privilégiés, les montages de l'hôte et les capabilities supplémentaires, et il doit être activé dans chaque namespace qui exécute des agents. Il ne change pas ce qui se trouve en dessous : un agent dans un pod entièrement conforme partage toujours le noyau du nœud avec tout le reste.
Que sont les user namespaces ? Une fonctionnalité de Linux, en disponibilité générale dans Kubernetes depuis la version 1.36, qui fait correspondre le root d'un conteneur à un utilisateur ordinaire sur l'hôte. Elle limite ce qu'une évasion peut faire, mais le noyau reste partagé.
Qu'est-ce que gVisor ? Un noyau écrit en espace utilisateur qui se place entre un conteneur et le noyau de l'hôte et répond lui-même à la plupart des appels système. Il restreint ce qui atteint le noyau de l'hôte, au prix d'une certaine perte de performances en I/O.
Dois-je renoncer à Kubernetes ? Non. Kubernetes peut continuer à ordonnancer et à gérer vos charges de travail pendant qu'un runtime basé sur des VM, comme Kata Containers, fournit l'isolation en dessous. Le changement porte sur ce qui se trouve sous le pod, pas sur la façon dont vous exploitez le cluster.
Chaque agent d'IA a-t-il besoin d'une microVM ? Non. Un agent qui appelle seulement un ensemble fixe d'API contrôlées et n'exécute aucun code généré est bien plus proche d'un service ordinaire, et un conteneur durci peut lui suffire. Le risque augmente quand l'agent peut écrire et exécuter des choses que personne n'a relues.
Qu'est-ce que Kata Containers ? Un runtime open source qui exécute chaque pod Kubernetes dans sa propre machine virtuelle légère, en utilisant un hyperviseur comme QEMU, Cloud Hypervisor, Firecracker ou Dragonball. Le cluster voit toujours un pod ordinaire.
Qu'est-ce que Firecracker ? Un moniteur de machine virtuelle open source conçu par AWS et utilisé derrière Lambda et Fargate. Sa documentation situe le démarrage jusqu'à l'init de l'invité à environ 125 millisecondes, avec moins de 5 MiB de surcoût mémoire par microVM.
Qu'est-ce qu'Agent Sandbox ? Un projet de SIG Apps de Kubernetes lancé en novembre 2025. Il ajoute une ressource Sandbox pour des runtimes d'agents isolés et avec état, reposant sur gVisor ou Kata Containers, avec des pools préchauffés qui ramènent le démarrage sous la seconde.
Comment trouver les pods d'agents à risque dans mon cluster ? Recherchez privileged: true, les sockets Docker montés, les capabilities ajoutées et les volumes hostPath dans tout namespace qui exécute des agents. Appliquer le Pod Security Standard Baseline transforme chacun d'eux en requête rejetée ou en exception relue.
Une microVM arrête-t-elle l'injection de prompt ? Non. Elle limite ce qu'un agent détourné peut atteindre sur l'hôte, mais un agent autorisé à appeler un outil ou une destination approuvés peut toujours être amené à en faire un mauvais usage. Les identifiants gardés hors du sandbox, le trafic sortant refusé par défaut et la journalisation à la frontière couvrent le reste.
Les microVM coûtent-elles plus cher à exploiter ? Elles exigent KVM, ce qui signifie du bare metal ou de la virtualisation imbriquée, et chaque sandbox ajoute un certain surcoût en mémoire et au démarrage. Les pools préchauffés et les snapshots réduisent le temps de démarrage, mais chaque clone restauré a besoin de sa propre identité et de ses propres clés.
Cheick M Ouedraogo a passé environ huit ans dans la vente de technologies pour les entreprises, notamment chez VMware et Broadcom, avant de fonder Aurakore, où il construit une infrastructure de virtualisation et d'IA privée. Il écrit sur ce que les acheteurs devraient demander et sur ce que dit réellement la documentation.
Sources
- runc container breakout vulnerabilities: a technical overview, CNCF, nov. 2025
- runc security advisory GHSA-cgrx-mc8f-2prm (CVE-2025-52881), projet runc
- runc security advisory GHSA-xr7r-f8xq-vfvv (CVE-2024-21626), projet runc, janv. 2024
- Kubernetes v1.36: User Namespaces in Kubernetes are finally GA, blog Kubernetes, avr. 2026
- Pod Security Standards, documentation Kubernetes
- Firecracker snapshot support, projet Firecracker
- New runc vulnerabilities allow container escape, Sysdig, nov. 2025
- Running Agents on Kubernetes with Agent Sandbox, blog Kubernetes, mars 2026
- Unleashing autonomous AI agents: why Kubernetes needs a new standard for agent execution, Google Open Source Blog, nov. 2025
- Kubernetes Agent Sandbox guide, Pulumi
- AI Agent Sandboxing Explained: Why Docker Is Not Enough, SoftwareSeni
- Firecracker, secure and fast microVMs, projet Firecracker
- Firecracker: lightweight virtualization for serverless, LWN.net
- MCP Security: 30 CVEs in 60 Days, Noqta
- MCP Security Vulnerabilities: Complete Threat Inventory, Obsidian Security
- Agent Compute Engine deep dive, blog Google Cloud, oct. 2026
- AI Agent Sandboxing, Prediction Guard, mis à jour en août 2026
Cet article porte sur Aurakore Virtualization.
Découvrir Aurakore Virtualization