Compartilhar uma GPU sem compartilhar seus dados: passthrough, vGPU e MIG comparados
Compartilhar uma GPU é uma troca entre três fatores: isolamento, aproveitamento e operabilidade. Uma comparação para compradores entre passthrough, vGPU por compartilhamento de tempo e MIG, o que acontece na noite dos patches e seis perguntas para fazer a qualquer plataforma.
Compartilhar uma GPU é uma troca entre três fatores, isolamento, aproveitamento e operabilidade, e a maioria das apresentações de plataformas só fala dos dois primeiros. O terceiro é onde as equipes são pegas de surpresa: o que acontece com uma carga de trabalho de GPU quando é preciso aplicar patches no host.
À medida que modelos privados e agentes passam para hardware compartilhado, é cada vez mais comum uma GPU cara atender várias equipes. Passei cerca de oito anos vendendo infraestrutura da VMware e da Broadcom, então escrevo isto do lado do comprador: o que perguntar, o que conferir e onde a documentação acaba. Este artigo compara as três principais formas de compartilhar uma GPU e as perguntas que as diferenciam.
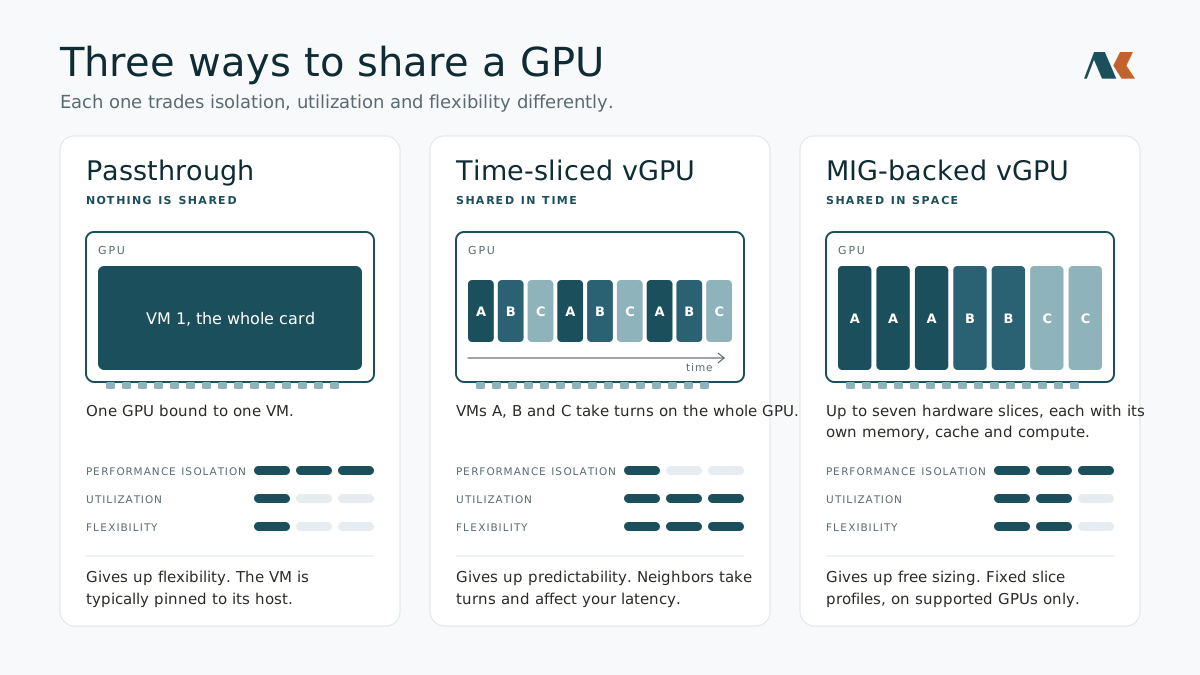
Três formas de compartilhar uma GPU
| Método | O que é compartilhado | Isolamento | Impacto nas operações |
|---|---|---|---|
| Passthrough | Nada. Uma GPU é vinculada a uma VM | O mais forte e o mais simples | O estado do dispositivo fica na placa, então a VM normalmente fica presa ao seu host |
| vGPU por compartilhamento de tempo | A GPU inteira, multiplexada no tempo | A memória é isolada pela IOMMU; o isolamento de desempenho é temporal, então os vizinhos afetam a sua latência | A migração em tempo real é suportada nas versões atuais do vSphere e do KVM, mas a memória da GPU precisa ser copiada |
| Baseada em MIG (Multi-Instance GPU) | Fatias de hardware, até sete por GPU | Espacial: cada fatia tem sua própria memória, cache e computação, com isolamento de falhas e throughput previsível | Perfis de fatia predefinidos; uma fatia MIG por VM, e uma GPU roda perfis MIG ou de compartilhamento de tempo, não os dois. Apenas GPUs compatíveis: a NVIDIA lista Ampere, Hopper e Blackwell, enquanto o guia de design do VCF 9.1 da Broadcom lista Ampere e Hopper |
A própria documentação da NVIDIA traça a linha com clareza. As vGPUs por compartilhamento de tempo se revezam na GPU inteira, então os processos rodam em série. As vGPUs baseadas em MIG recebem partições de hardware dedicadas e rodam de fato em paralelo, e é por isso que a NVIDIA as recomenda para trabalho multilocatário e latência consistente.
Um cuidado sobre a tabela: ali, "isolamento" significa duas coisas diferentes, e elas falham de formas diferentes.
Isolamento são duas perguntas: desempenho e dados
O isolamento de desempenho pergunta se um vizinho barulhento pode prejudicar a sua latência. O compartilhamento de tempo diz que sim, por design. O MIG diz que não, porque os recursos são divididos fisicamente. Para inferência com metas de latência, esse costuma ser o fator decisivo.
O isolamento de dados pergunta se um locatário consegue ler as sobras de outro. É o que as pessoas presumem e raramente testam. A vulnerabilidade LeftoverLocals (CVE-2023-4969), divulgada pela Trail of Bits em janeiro de 2024, mostrou que, nas GPUs afetadas da AMD, Apple, Qualcomm e Imagination, um processo conseguia ler dados que um processo anterior havia deixado na memória local da GPU, incluindo trechos da sessão de LLM de outro usuário. Os pesquisadores relataram que os dispositivos da NVIDIA e da Arm não foram afetados.
A lição não é sobre um fornecedor específico. O artigo deles observa que abordagens de particionamento conservadoras, como a vGPU, dividem fisicamente a GPU e por isso provavelmente evitam esse tipo de vazamento, mas dizem que não têm provas conclusivas. Enquanto isso, simplesmente compartilhar uma GPU por meio do escalonamento multiprocesso comum bastou para expor o problema, inclusive dentro de contêineres.
Se a memória é limpa entre locatários, e por qual mecanismo, é uma propriedade sobre a qual você precisa perguntar, não presumir.
A parte que ninguém coloca no orçamento: as operações
Uma VM com uma GPU conectada carrega muito estado. Para migrá-la em tempo real, a plataforma também precisa copiar a memória da GPU, e a VM é pausada para a troca final.
Isso já foi um problema operacional sério, e mostra por que as afirmações dos fornecedores precisam de datas. No vSphere 7 e no 8.0 antes do Update 2, o DRS não tirava automaticamente as VMs com vGPU de um host que entrava em modo de manutenção, porque a pausa podia passar de 100 segundos, então os administradores as moviam manualmente. O vSphere 8.0 Update 2 permitiu que o DRS estimasse a pausa e automatizasse a movimentação quando ela fica abaixo de um limite configurável, 100 segundos por padrão, depois que um administrador ativa essa automação. No VCF 9.1 isso ainda precisa ser ativado: o guia de design 9.1 da Broadcom diz que, por padrão, o DRS deixa as VMs com vGPU para correção manual, e só as move automaticamente para balanceamento de carga ou manutenção quando a configuração PassthroughDrsAutomation está ativada.
O VMware Cloud Foundation 9.0 (junho de 2025) mudou o cenário. A Broadcom refez a forma como o vMotion copia o checkpoint da vGPU, substituindo um canal de thread única por um multithread. As notas de versão do VCF 9.0 e o guia de design 9.1 da Broadcom explicam o resto: a partir do ESX 9.0, o vMotion distingue a memória estática da GPU da memória que está mudando. A parte estática, que a Broadcom estima em cerca de 70% para inferência de LLM e que é principalmente os pesos do modelo, é copiada enquanto a VM continua rodando; só os dados que mudam, como o KV cache, são copiados durante a pausa. A Broadcom relata pausas de três a quatro vezes menores que no vSphere 8.0 Update 3. Nos testes dela, uma VM com oito GPUs H100 de 80 GB ficou pausada por 21 segundos, uma configuração que atingia o limite padrão de 100 segundos no 8.0 Update 3. A Broadcom agora considera o vMotion viável para perfis de vGPU de 48 GB, 80 GB e maiores.
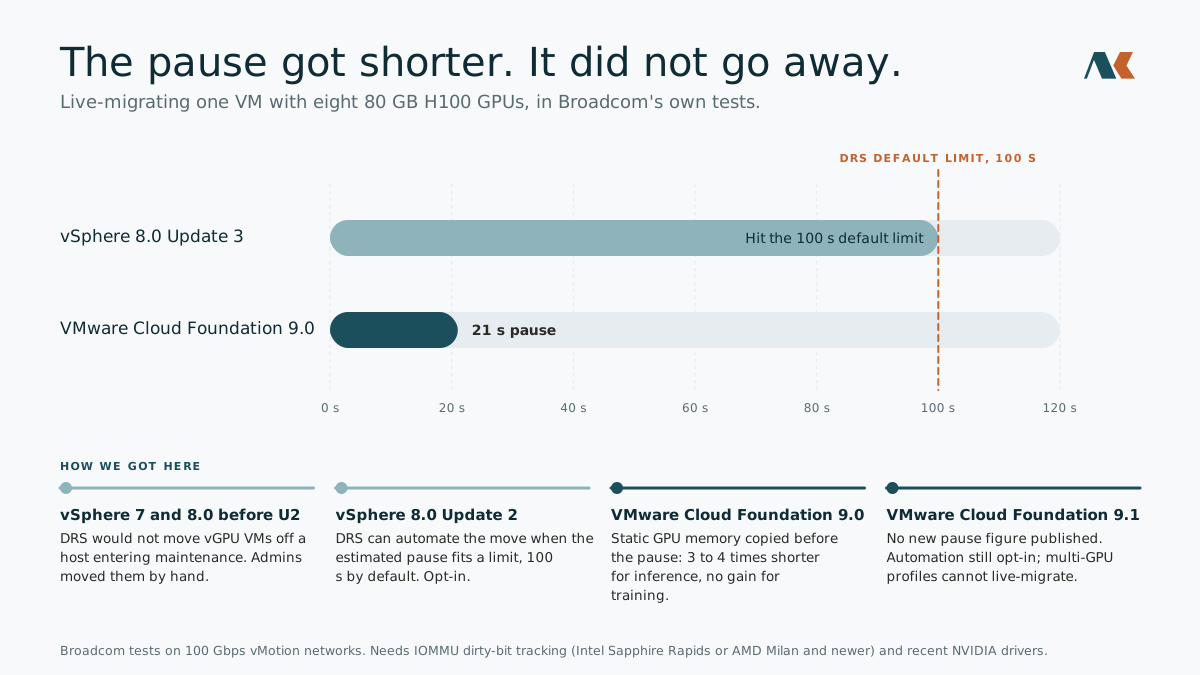
Leia esses resultados com as suas condições. São testes da própria Broadcom em redes de vMotion de 100 Gbps, e os ganhos dependem do rastreamento de dirty bits da IOMMU, que exige Intel Sapphire Rapids ou mais recente, ou AMD Milan ou mais recente, junto com gerações recentes de drivers da NVIDIA. A pausa continua existindo; ela é mais curta. Qualquer plataforma que migre em tempo real uma VM com GPU conectada precisa mover a memória da GPU, então as perguntas úteis são sobre as condições: quais CPUs, qual rede, quais drivers e quanta pausa a sua carga de trabalho tolera.
O VCF 9.1 não publicou uma pausa mais curta. O FAQ do vSphere 9.1 da Broadcom lista "vMotion mais rápido para cargas de trabalho de GPU" entre os destaques da versão, mas nem as notas de versão do 9.1 nem o guia de design do 9.1 trazem um número novo ou um mecanismo novo para vGPU. O que o 9.1 acrescenta é uma estimativa do tempo de inatividade do vMotion no vCenter para VMs com dispositivos Enhanced DirectPath. O guia de design mantém o mecanismo do ESX 9.0 e o mesmo padrão de 100 segundos, e há duas ressalvas. As notas de versão do 9.0 da Broadcom dizem que a pré-cópia ajuda a inferência de IA generativa, mas não tem impacto em cargas de trabalho gráficas e de treinamento. E as VMs que usam Unified Virtual Memory, exigida pelos perfis multi-GPU, não podem ser migradas em tempo real de forma alguma e precisam ser desligadas para a manutenção.
Para inferência sem estado, muitas vezes a melhor resposta é a evacuação por substituição: rodar réplicas em vários hosts, esvaziar um e deixar os outros absorverem o tráfego. Isso transforma a manutenção do host de um problema de migração em um problema de escalonamento. É uma escolha de design, não uma garantia, e funciona melhor quando as fatias são dimensionadas para que qualquer réplica possa assumir.
O VCF 9.1 ajuda no próprio esvaziamento, para todas as VMs e não só as que têm GPU. Uma nova opção do modo de manutenção evacua as VMs apenas quando os hosts restantes conseguem absorver a demanda delas, e o DRS pode rebalancear esses hosts antes. As tarefas de vMotion também começam à medida que cada uma termina, em vez de esperar a conclusão de um lote de oito.
A pilha por baixo
O NVIDIA vGPU não é um recurso do hipervisor por si só. É uma pilha em camadas: um driver de host do fornecedor instalado no hipervisor, um driver correspondente dentro de cada convidado e um serviço de licenciamento que os convidados precisam alcançar. Rodar IA em vGPU exige uma licença NVIDIA AI Enterprise, qualquer que seja o hipervisor que você use.
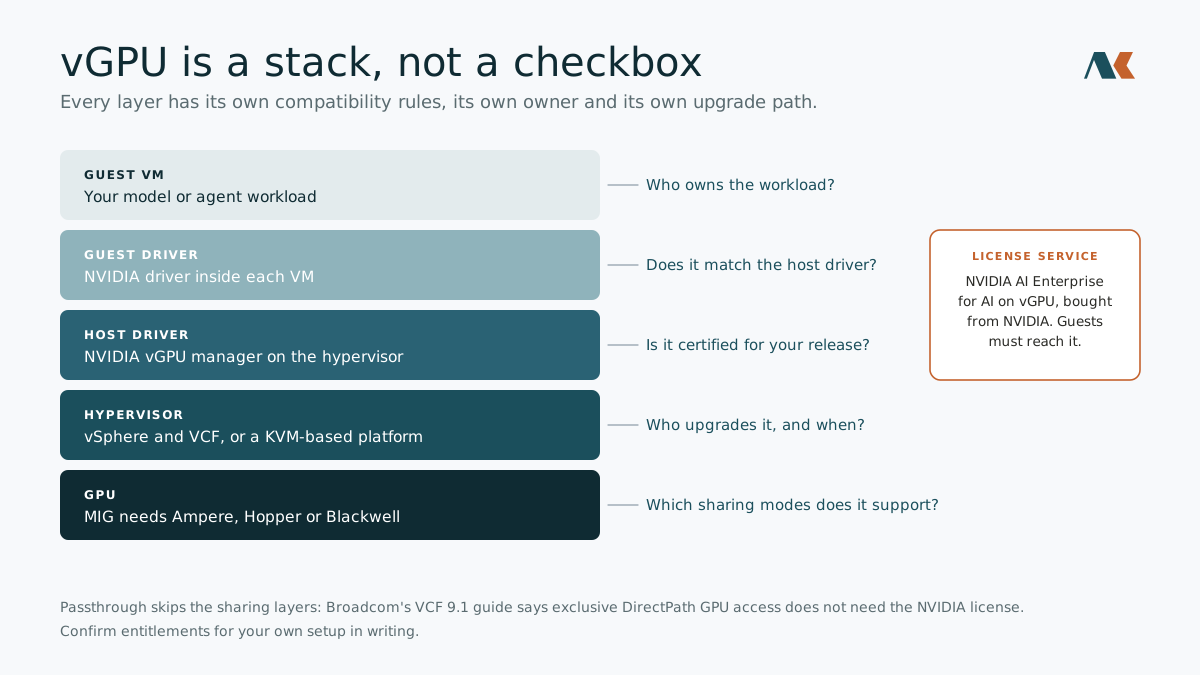
No VMware Cloud Foundation, os direitos de uso vêm mudando. A Broadcom anunciou no VMware Explore 2025 que o Private AI Foundation with NVIDIA passou a fazer parte da assinatura padrão do VCF, embora parte da documentação da Broadcom ainda mencione uma licença adicional separada, então confirme os seus direitos de uso por escrito. A licença NVIDIA AI Enterprise continua sendo comprada da NVIDIA, não da Broadcom. O guia do VCF 9.1 da Broadcom diz que o acesso exclusivo à GPU via DirectPath passthrough não exige a licença da NVIDIA, o que está de acordo com a própria documentação de certificação de hipervisores da NVIDIA.
Cada camada tem as suas próprias regras de compatibilidade. A página de requisitos da Broadcom diz que o driver de host da NVIDIA precisa ser compatível com a sua versão do VCF, e o vMotion mais rápido descrito acima depende de gerações mais novas de drivers. Isso é rotina, e é por isso que o compartilhamento de GPU deve ser avaliado como uma pilha com responsáveis e caminhos de atualização, não como uma caixa de seleção. O mesmo vale para plataformas baseadas em KVM, em que cada fornecedor integra a versão genérica de vGPU para KVM da NVIDIA.
Seis perguntas para fazer a qualquer plataforma
- O isolamento é temporal ou espacial? O job de um vizinho vai mudar a minha latência?
- O que é limpo entre locatários, e quem confere isso? Peça o mecanismo, não a promessa.
- Como esvazio um host de GPU para manutenção? O que acontece com as cargas de trabalho em execução, e por quanto tempo elas ficam pausadas?
- Do que depende a pilha de compartilhamento? Quais componentes, quais licenças e quem aplica os patches em cada um?
- Consigo redimensionar as partições sem uma janela de manutenção? As instâncias MIG podem ser reconfiguradas, mas confira o que a plataforma permite enquanto as cargas de trabalho rodam.
- Consigo atribuir o uso da GPU a cada locatário? O chargeback e o planejamento de capacidade precisam disso.
A conclusão
Escolher um modo de compartilhamento de GPU é escolher como falhar: a latência de quem sofre, os dados de quem podem vazar e o que acontece na noite dos patches.
O passthrough maximiza o isolamento e abre mão da flexibilidade. O compartilhamento de tempo maximiza o aproveitamento e abre mão da previsibilidade. O particionamento no estilo MIG oferece fatias previsíveis e isoladas ao custo de tamanhos fixos e hardware compatível.
Seja qual for a sua escolha, avalie a pilha inteira e as operações em torno dela. A plataforma que responde às seis perguntas com clareza costuma ser a que já enfrentou os problemas por trás delas.
Perguntas frequentes
O que é uma vGPU? É um software que permite que várias máquinas virtuais compartilhem uma GPU física. Cada máquina vê a sua própria GPU virtual, e o driver do host decide quanto da placa real cada uma recebe.
O que é MIG? Multi-Instance GPU é um recurso da NVIDIA que divide em hardware uma GPU compatível em até sete partes separadas. Cada parte tem sua própria memória e computação, então a carga de trabalho de um locatário não consegue deixar a de outro mais lenta.
Qual é a diferença entre passthrough e vGPU? O passthrough dá a GPU inteira a uma máquina virtual, então nada é compartilhado. A vGPU divide uma GPU entre várias máquinas, o que aproveita melhor a placa, mas acrescenta regras de compartilhamento para gerenciar.
Outro locatário pode ver os meus dados em uma GPU compartilhada? Depende de como a GPU é compartilhada e de como a memória é limpa entre os usuários. Uma falha de 2024 chamada LeftoverLocals permitia que um processo lesse dados deixados por outro em algumas GPUs da AMD, Apple, Qualcomm e Imagination. É por isso que a pergunta a fazer é o que é limpo e quem confere isso.
O que é migração em tempo real, e por que uma GPU a torna mais difícil? A migração em tempo real move uma máquina virtual em execução para outro servidor sem desligá-la. Com uma GPU conectada, a plataforma também precisa copiar a memória da GPU, então a máquina fica pausada por um curto período no final. Versões mais novas encurtam essa pausa, mas ela não desaparece, e VMs que usam perfis multi-GPU não podem ser migradas em tempo real de forma alguma.
Preciso de uma licença separada da NVIDIA? Rodar IA em vGPU exige uma licença NVIDIA AI Enterprise, que você compra da NVIDIA qualquer que seja o hipervisor que use. O guia do VCF 9.1 da Broadcom diz que o passthrough, em que uma VM recebe uma GPU inteira, não a exige. Confirme por escrito as condições para a sua própria configuração antes de comprar.
Cheick M Ouedraogo passou cerca de oito anos em vendas de tecnologia corporativa, incluindo VMware e Broadcom, antes de fundar a Aurakore, onde constrói infraestrutura de virtualização e de IA privada. Ele escreve sobre o que os compradores devem perguntar e o que a documentação realmente diz.
Fontes
- NVIDIA vGPU Types Reference, documentação do NVIDIA AI Enterprise
- NVIDIA vGPU for Compute, documentação do NVIDIA AI Enterprise
- NVIDIA Virtual GPU Knowledge Base: vGPU features across hypervisors, NVIDIA
- NVIDIA Multi-Instance GPU, NVIDIA
- Enhanced vMotion for vGPU VMs in VMware Cloud Foundation 9.0, blog do VCF da Broadcom, junho de 2025
- New Tuning Settings for DRS and vMotion for VMs with Virtual GPUs in vSphere 8.0 Update 2, blog do VCF da Broadcom, set. de 2023
- vSphere Lifecycle Manager is unable to place a host into maintenance mode if it has a running vGPU Virtual Machine, base de conhecimento da Broadcom
- Requirements for Deploying VMware Private AI Foundation with NVIDIA, Broadcom TechDocs
- VMware Private AI Foundation with NVIDIA 9.1, Broadcom TechDocs
- LeftoverLocals: Listening to LLM Responses Through Leaked GPU Local Memory, Trail of Bits
- AMD, Apple, Qualcomm, Imagination GPUs could leak AI secrets via LeftoverLocals, SC Media
- Apple, AMD, Qualcomm GPU security hole lets miscreants snoop on AI training and chats, The Register
- Broadcom bundles private AI into VCF, adds security automation, Computer Weekly
- vGPU Compute Model, VMware Cloud Foundation 9.1 design guide, Broadcom TechDocs
- What's New: vSphere, VMware Cloud Foundation 9.0 release notes, Broadcom TechDocs
- What's New: vSphere, VMware Cloud Foundation 9.1 release notes, Broadcom TechDocs
- vSphere with VCF 9.1 General FAQ, VMware, maio de 2026
- What's New with vSphere in VMware Cloud Foundation 9.1, blog do VCF da Broadcom, maio de 2026
- NVIDIA-Certified Hypervisors, NVIDIA
Este artigo é sobre Aurakore Virtualization.
Conheça Aurakore Virtualization