Partager un GPU sans partager vos données : passthrough, vGPU et MIG comparés
Partager un GPU est un arbitrage à trois termes entre isolation, utilisation et exploitabilité. Une comparaison pour les acheteurs entre passthrough, vGPU en temps partagé et MIG, ce qui se passe le soir des correctifs, et six questions à poser à toute plateforme.
Partager un GPU est un arbitrage à trois termes entre isolation, utilisation et exploitabilité, et la plupart des présentations de plateformes ne parlent que des deux premiers. C'est le troisième qui prend les équipes par surprise : ce qui arrive à une charge de travail GPU quand il faut appliquer des correctifs à l'hôte.
À mesure que les modèles privés et les agents passent sur du matériel partagé, il devient de plus en plus courant qu'un GPU coûteux serve plusieurs équipes. J'ai passé environ huit ans à vendre de l'infrastructure VMware et Broadcom, j'écris donc ceci du côté de l'acheteur : quoi demander, quoi contrôler, et où s'arrête la documentation. Cet article compare les trois principales façons de partager un GPU, et les questions qui les distinguent.
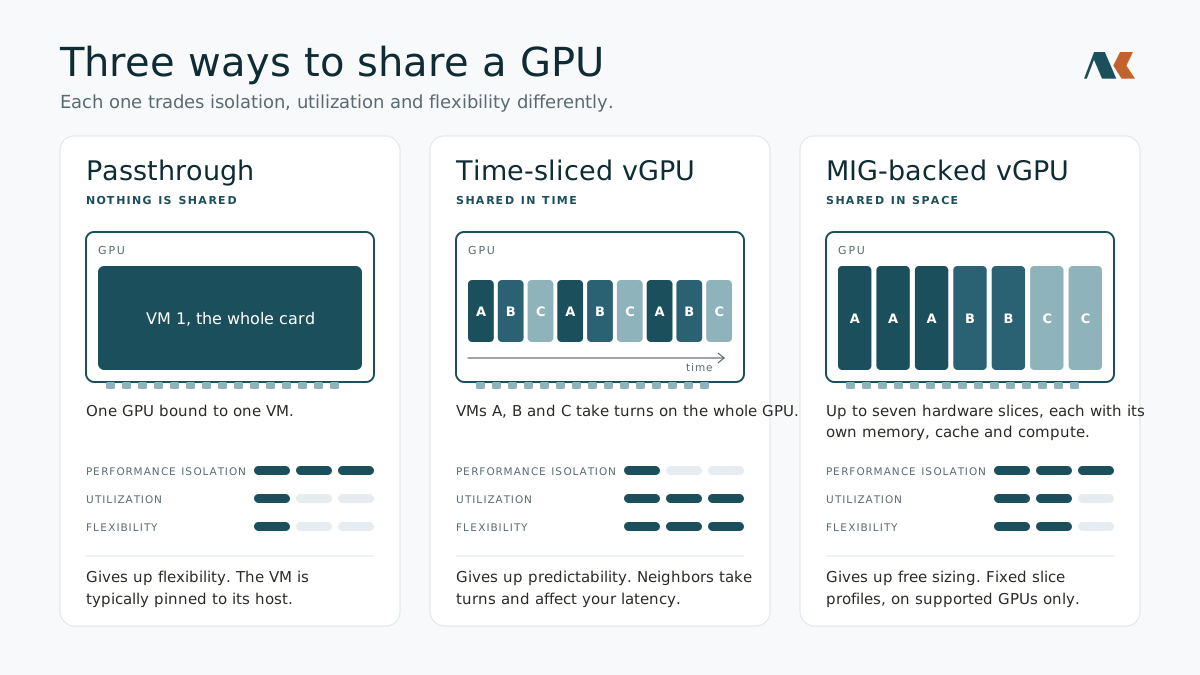
Trois façons de partager un GPU
| Méthode | Ce qui est partagé | Isolation | Impact sur l'exploitation |
|---|---|---|---|
| Passthrough | Rien. Un GPU est attaché à une VM | La plus forte et la plus simple | L'état du périphérique réside dans la carte, si bien que la VM est généralement liée à son hôte |
| vGPU en temps partagé | Le GPU entier, multiplexé dans le temps | La mémoire est isolée par l'IOMMU ; l'isolation des performances est temporelle, donc les voisins affectent votre latence | La migration à chaud est prise en charge sur les versions actuelles de vSphere et de KVM, mais la mémoire du GPU doit être copiée |
| Basé sur MIG (Multi-Instance GPU) | Des tranches matérielles, jusqu'à sept par GPU | Spatiale : chaque tranche a sa propre mémoire, son cache et sa capacité de calcul, avec isolation des pannes et débit prévisible | Profils de tranche prédéfinis ; une tranche MIG par VM, et un GPU exécute des profils MIG ou en temps partagé, pas les deux. GPU compatibles uniquement : NVIDIA cite Ampere, Hopper et Blackwell, tandis que le guide de conception VCF 9.1 de Broadcom cite Ampere et Hopper |
La documentation de NVIDIA elle-même trace clairement la ligne. Les vGPU en temps partagé se relaient sur le GPU entier, donc les processus s'exécutent en série. Les vGPU basés sur MIG obtiennent des partitions matérielles dédiées et s'exécutent réellement en parallèle, c'est pourquoi NVIDIA les recommande pour les usages multilocataires et une latence constante.
Une mise en garde sur ce tableau : « isolation » y désigne deux choses différentes, qui échouent de façons différentes.
L'isolation, ce sont deux questions : performances et données
L'isolation des performances demande si un voisin bruyant peut dégrader votre latence. Le temps partagé répond oui, par conception. MIG répond non, car les ressources sont physiquement divisées. Pour l'inférence avec des objectifs de latence, c'est généralement le facteur décisif.
L'isolation des données demande si un locataire peut lire les restes d'un autre. C'est celle que l'on suppose et que l'on teste rarement. La vulnérabilité LeftoverLocals (CVE-2023-4969), divulguée par Trail of Bits en janvier 2024, a montré que sur les GPU AMD, Apple, Qualcomm et Imagination concernés, un processus pouvait lire des données qu'un processus précédent avait laissées dans la mémoire locale du GPU, y compris des fragments de la session LLM d'un autre utilisateur. Les chercheurs ont indiqué que les appareils NVIDIA et Arm n'étaient pas concernés.
La leçon ne porte sur aucun fournisseur en particulier. Leur article note que les approches de partitionnement prudentes comme le vGPU divisent physiquement le GPU et évitent donc probablement ce type de fuite, mais ils disent ne pas disposer de preuves concluantes. Dans le même temps, il suffisait de partager un GPU au moyen de l'ordonnancement multiprocessus ordinaire pour exposer le problème, y compris dans des conteneurs.
Que la mémoire soit effacée entre locataires, et par quel mécanisme, est une propriété sur laquelle il faut poser la question, pas une hypothèse.
La partie que personne ne budgète : l'exploitation
Une VM à laquelle un GPU est attaché porte beaucoup d'état. Pour la migrer à chaud, la plateforme doit aussi copier la mémoire du GPU, et la VM est mise en pause pour la bascule finale.
C'était autrefois un vrai problème d'exploitation, et cela montre pourquoi les affirmations des fournisseurs doivent être datées. Sur vSphere 7 et sur 8.0 avant l'Update 2, DRS ne déplaçait pas automatiquement les VM vGPU hors d'un hôte entrant en mode maintenance, car la pause pouvait dépasser 100 secondes, si bien que les administrateurs les déplaçaient à la main. vSphere 8.0 Update 2 a permis à DRS d'estimer la pause et d'automatiser le déplacement lorsqu'elle reste sous une limite configurable, 100 secondes par défaut, une fois qu'un administrateur active cette automatisation. Sur VCF 9.1, il faut toujours l'activer : le guide de conception 9.1 de Broadcom indique que, par défaut, DRS laisse les VM vGPU à une remédiation manuelle, et ne les déplace automatiquement pour l'équilibrage de charge ou la maintenance que lorsque le paramètre PassthroughDrsAutomation est activé.
VMware Cloud Foundation 9.0 (juin 2025) a changé la donne. Broadcom a revu la façon dont vMotion copie le point de contrôle du vGPU, en remplaçant un canal monothread par un canal multithread. Les notes de version de VCF 9.0 et le guide de conception 9.1 de Broadcom expliquent le reste : à partir d'ESX 9.0, vMotion distingue la mémoire GPU statique de la mémoire qui change. La partie statique, que Broadcom estime à environ 70 % pour l'inférence LLM et qui correspond surtout aux poids du modèle, est copiée pendant que la VM continue de tourner ; seules les données qui changent, comme le KV cache, sont copiées pendant la pause. Broadcom fait état de pauses trois à quatre fois plus courtes qu'avec vSphere 8.0 Update 3. Dans ses tests, une VM dotée de huit GPU H100 de 80 Go a été mise en pause 21 secondes, une configuration qui atteignait la limite par défaut de 100 secondes sous 8.0 Update 3. Broadcom juge désormais vMotion praticable pour les profils vGPU de 48 Go, 80 Go et plus.
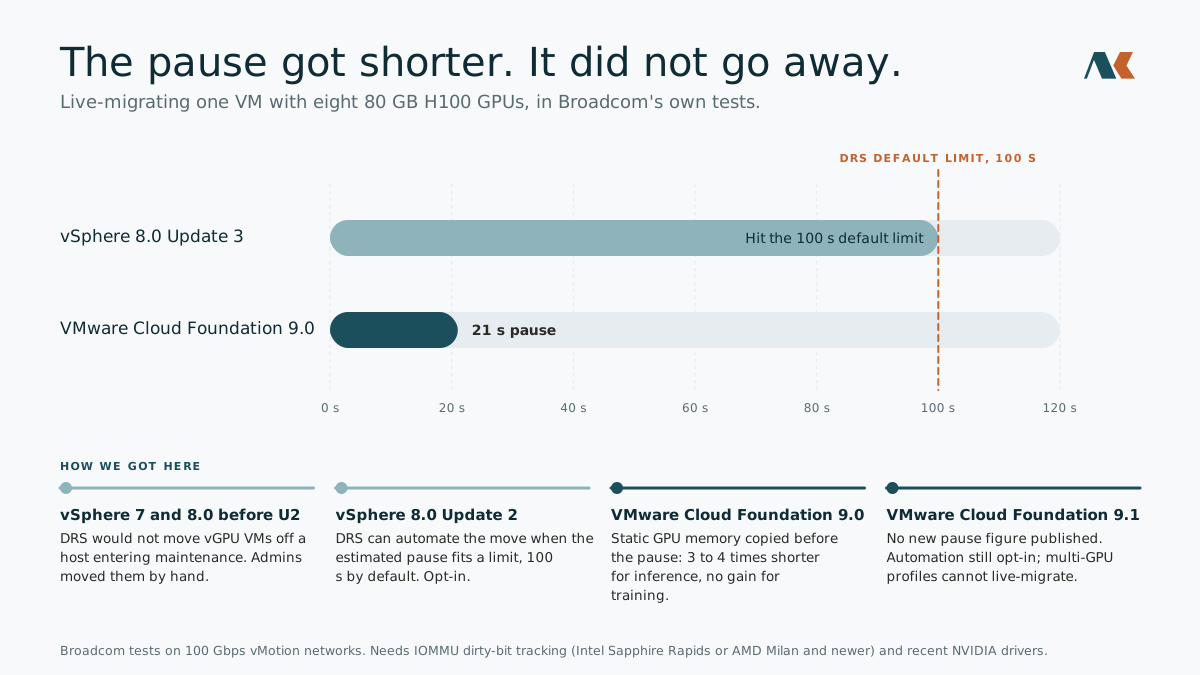
Lisez ces résultats avec leurs conditions. Ce sont les propres tests de Broadcom sur des réseaux vMotion à 100 Gbit/s, et les gains dépendent du suivi des bits modifiés (dirty bits) par l'IOMMU, qui exige Intel Sapphire Rapids ou plus récent, ou AMD Milan ou plus récent, ainsi que des générations récentes de pilotes NVIDIA. La pause existe toujours ; elle est plus courte. Toute plateforme qui migre à chaud une VM dotée d'un GPU doit déplacer la mémoire du GPU, donc les questions utiles portent sur les conditions : quels processeurs, quel réseau, quels pilotes, et quelle durée de pause votre charge de travail tolère.
VCF 9.1 n'a pas publié de pause plus courte. La FAQ vSphere 9.1 de Broadcom cite « un vMotion plus rapide pour les charges de travail GPU » parmi les points forts de la version, mais ni les notes de version 9.1 ni le guide de conception 9.1 ne donnent de nouveau chiffre ni de nouveau mécanisme pour le vGPU. Ce que 9.1 ajoute, c'est une estimation du temps d'arrêt de vMotion dans vCenter pour les VM dotées de périphériques Enhanced DirectPath. Le guide de conception reprend le mécanisme d'ESX 9.0 et la même valeur par défaut de 100 secondes, et deux réserves s'appliquent. Les notes de version 9.0 de Broadcom indiquent que la pré-copie aide l'inférence d'IA générative mais n'a aucun effet sur les charges de travail graphiques et d'entraînement. Et les VM qui utilisent Unified Virtual Memory, qu'exigent les profils multi-GPU, ne peuvent pas du tout être migrées à chaud et doivent être éteintes pour la maintenance.
Pour l'inférence sans état, la meilleure réponse est souvent l'évacuation par remplacement : exécuter des répliques sur plusieurs hôtes, en vider un et laisser les autres absorber le trafic. La maintenance d'un hôte passe ainsi d'un problème de migration à un problème d'ordonnancement. C'est un choix de conception, pas une garantie, et cela fonctionne mieux quand les tranches sont dimensionnées pour que n'importe quelle réplique puisse prendre le relais.
VCF 9.1 aide pour le vidage lui-même, pour toutes les VM et pas seulement celles dotées d'un GPU. Une nouvelle option du mode maintenance n'évacue les VM que lorsque les hôtes restants peuvent absorber leur demande, et DRS peut d'abord rééquilibrer ces hôtes. Les tâches vMotion démarrent aussi au fur et à mesure que chacune se termine, au lieu d'attendre qu'un lot de huit soit achevé.
La pile sous-jacente
NVIDIA vGPU n'est pas à lui seul une fonction de l'hyperviseur. C'est une pile en couches : un pilote hôte du fournisseur installé sur l'hyperviseur, un pilote correspondant dans chaque invité, et un service de licences que les invités doivent pouvoir joindre. Exécuter de l'IA sur vGPU exige une licence NVIDIA AI Enterprise, quel que soit l'hyperviseur que vous utilisez.
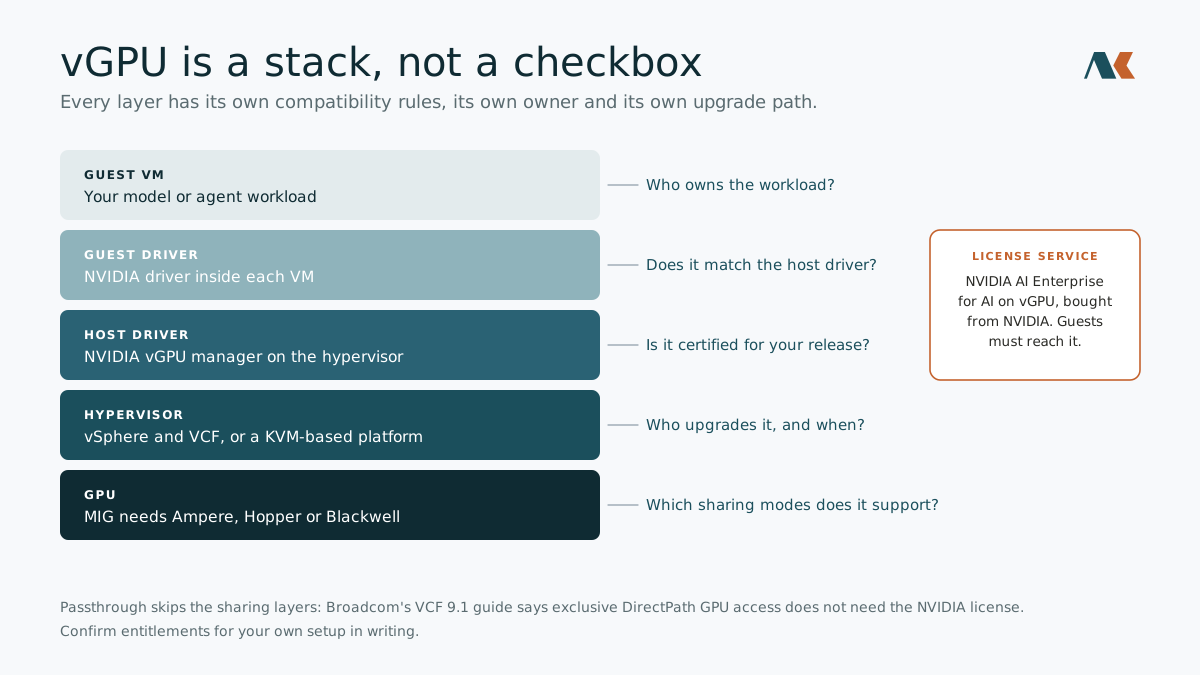
Sur VMware Cloud Foundation, les droits d'utilisation ont évolué. Broadcom a annoncé lors de VMware Explore 2025 que Private AI Foundation with NVIDIA intégrait l'abonnement VCF standard, même si une partie de la documentation de Broadcom mentionne encore une licence complémentaire distincte : confirmez donc vos droits d'utilisation par écrit. La licence NVIDIA AI Enterprise s'achète toujours auprès de NVIDIA, pas de Broadcom. Le guide VCF 9.1 de Broadcom indique que l'accès exclusif au GPU par DirectPath passthrough n'exige pas la licence NVIDIA, ce qui concorde avec la documentation de certification des hyperviseurs de NVIDIA elle-même.
Chaque couche a ses propres règles de compatibilité. La page des prérequis de Broadcom indique que le pilote hôte NVIDIA doit être compatible avec votre version de VCF, et le vMotion plus rapide décrit plus haut repose sur des générations de pilotes plus récentes. C'est la routine, et c'est pourquoi le partage de GPU doit être évalué comme une pile avec des responsables et des chemins de mise à niveau, pas comme une case à cocher. Il en va de même sur les plateformes basées sur KVM, où chaque fournisseur intègre la version générique de vGPU pour KVM de NVIDIA.
Six questions à poser à toute plateforme
- L'isolation est-elle temporelle ou spatiale ? La tâche d'un voisin va-t-elle modifier ma latence ?
- Qu'est-ce qui est effacé entre locataires, et qui le contrôle ? Demandez le mécanisme, pas l'assurance.
- Comment vider un hôte GPU pour la maintenance ? Qu'arrive-t-il aux charges de travail en cours, et combien de temps sont-elles en pause ?
- De quoi dépend la pile de partage ? Quels composants, quelles licences, et qui applique les correctifs à chacun ?
- Puis-je redimensionner les partitions sans fenêtre de maintenance ? Les instances MIG peuvent être reconfigurées, mais contrôlez ce que la plateforme autorise pendant que les charges de travail tournent.
- Puis-je attribuer l'usage du GPU à chaque locataire ? La refacturation interne et la planification de capacité en ont besoin.
À retenir
Choisir un mode de partage de GPU, c'est choisir comment échouer : la latence de qui en souffre, les données de qui pourraient fuir, et ce qui se passe le soir des correctifs.
Le passthrough maximise l'isolation et renonce à la flexibilité. Le temps partagé maximise l'utilisation et renonce à la prévisibilité. Le partitionnement de type MIG offre des tranches prévisibles et isolées, au prix de tailles fixes et d'un matériel compatible.
Quel que soit votre choix, évaluez la pile entière et l'exploitation qui l'entoure. La plateforme qui répond simplement aux six questions est généralement celle qui a déjà rencontré les problèmes qui les motivent.
Questions fréquentes
Qu'est-ce qu'un vGPU ? C'est un logiciel qui permet à plusieurs machines virtuelles de partager un GPU physique. Chaque machine voit son propre GPU virtuel, et le pilote hôte décide de la part de la carte réelle que reçoit chacune.
Qu'est-ce que MIG ? Multi-Instance GPU est une fonction de NVIDIA qui découpe matériellement un GPU compatible en jusqu'à sept parties distinctes. Chaque partie a sa propre mémoire et sa propre capacité de calcul, de sorte que la charge de travail d'un locataire ne peut pas ralentir celle d'un autre.
Quelle est la différence entre passthrough et vGPU ? Le passthrough donne le GPU entier à une seule machine virtuelle, donc rien n'est partagé. Le vGPU répartit un GPU entre plusieurs machines, ce qui exploite mieux la carte mais ajoute des règles de partage à gérer.
Un autre locataire peut-il voir mes données sur un GPU partagé ? Cela dépend de la façon dont le GPU est partagé et dont la mémoire est effacée entre utilisateurs. Une faille de 2024 appelée LeftoverLocals permettait à un processus de lire des données laissées par un autre sur certains GPU AMD, Apple, Qualcomm et Imagination. C'est pourquoi la question à poser est : qu'est-ce qui est effacé, et qui le contrôle.
Qu'est-ce que la migration à chaud, et pourquoi un GPU la complique-t-il ? La migration à chaud déplace une machine virtuelle en cours d'exécution vers un autre serveur sans l'arrêter. Avec un GPU attaché, la plateforme doit aussi copier la mémoire du GPU, si bien que la machine est mise en pause un court instant à la fin. Les versions récentes raccourcissent cette pause, mais elle ne disparaît pas, et les VM qui utilisent des profils multi-GPU ne peuvent pas du tout être migrées à chaud.
Ai-je besoin d'une licence NVIDIA distincte ? Exécuter de l'IA sur vGPU exige une licence NVIDIA AI Enterprise, que vous achetez auprès de NVIDIA quel que soit l'hyperviseur utilisé. Le guide VCF 9.1 de Broadcom indique que le passthrough, où une VM reçoit un GPU entier, ne l'exige pas. Confirmez par écrit les conditions applicables à votre propre configuration avant d'acheter.
Cheick M Ouedraogo a passé environ huit ans dans la vente de technologies pour les entreprises, notamment chez VMware et Broadcom, avant de fonder Aurakore, où il construit une infrastructure de virtualisation et d'IA privée. Il écrit sur ce que les acheteurs devraient demander et sur ce que dit réellement la documentation.
Sources
- NVIDIA vGPU Types Reference, documentation NVIDIA AI Enterprise
- NVIDIA vGPU for Compute, documentation NVIDIA AI Enterprise
- NVIDIA Virtual GPU Knowledge Base: vGPU features across hypervisors, NVIDIA
- NVIDIA Multi-Instance GPU, NVIDIA
- Enhanced vMotion for vGPU VMs in VMware Cloud Foundation 9.0, blog VCF de Broadcom, juin 2025
- New Tuning Settings for DRS and vMotion for VMs with Virtual GPUs in vSphere 8.0 Update 2, blog VCF de Broadcom, sept. 2023
- vSphere Lifecycle Manager is unable to place a host into maintenance mode if it has a running vGPU Virtual Machine, base de connaissances Broadcom
- Requirements for Deploying VMware Private AI Foundation with NVIDIA, Broadcom TechDocs
- VMware Private AI Foundation with NVIDIA 9.1, Broadcom TechDocs
- LeftoverLocals: Listening to LLM Responses Through Leaked GPU Local Memory, Trail of Bits
- AMD, Apple, Qualcomm, Imagination GPUs could leak AI secrets via LeftoverLocals, SC Media
- Apple, AMD, Qualcomm GPU security hole lets miscreants snoop on AI training and chats, The Register
- Broadcom bundles private AI into VCF, adds security automation, Computer Weekly
- vGPU Compute Model, VMware Cloud Foundation 9.1 design guide, Broadcom TechDocs
- What's New: vSphere, VMware Cloud Foundation 9.0 release notes, Broadcom TechDocs
- What's New: vSphere, VMware Cloud Foundation 9.1 release notes, Broadcom TechDocs
- vSphere with VCF 9.1 General FAQ, VMware, mai 2026
- What's New with vSphere in VMware Cloud Foundation 9.1, blog VCF de Broadcom, mai 2026
- NVIDIA-Certified Hypervisors, NVIDIA
Cet article porte sur Aurakore Virtualization.
Découvrir Aurakore Virtualization